이 글은 Apptics 에디터가 구글 딥마인드 공식 발표문과 주요 외신 보도(Ars Technica, CNBC, 9to5Google, Axios)를 직접 대조해 정리한 해설 기사입니다. 벤치마크 수치는 공식 발표 및 공개 리더보드 기준입니다.
벤치마크 1위라는데, 왜 아무도 못 쓸까
9월 30일(현지시간), 구글이 새 프론티어 모델 Gemini 4 Argon을 공개했습니다. 소프트웨어 엔지니어링 벤치마크 신기록, 경제 파급력 지표 1위, 보안 취약점 탐지 공동 1위. 성적표만 보면 올해 나온 어떤 모델보다 화려합니다.
그런데 이상한 점이 하나 있어요. 정작 개발자는 오늘 이 모델을 호출할 수 없습니다. API도, Gemini 앱도, AI Ultra 구독에도 아직 등장하지 않았어요. 구글은 왜 1등 모델을 만들어 놓고 스스로 문을 걸어 잠갔을까요? 이 글에서는 Argon의 실체와 벤치마크, 가격, 그리고 ‘단계적 출시’ 뒤에 숨은 이유를 순서대로 풀어보겠습니다.
Gemini 4 Argon은 무엇인가 — 3.5 Pro를 건너뛴 이유
사정을 이해하려면 지난여름으로 거슬러 올라가야 합니다. 구글은 6월까지만 해도 ‘Gemini 3.5 Pro’를 약속했었지만, 결국 이 모델은 취소됐어요. 대신 가을 내내 작은 Flash 모델(3.8 Flash, 3.8 Flash Cyber)만 다듬어 내놨죠. 프론티어 경쟁에서는 한발 물러선 모습이었습니다.
그리고 이번 발표에서 구글은 버전 번호와 네이밍 체계를 통째로 바꿉니다. 3.5를 건너뛰고 ‘Gemini 4’ + 원소 이름(Argon, 아르곤)이라는 새 네이밍이 등장했어요. 구글의 표현을 빌리면 Argon은 “복잡하고 장기적인(long-horizon) 워크플로 전반에서 깊은 추론을 지속하도록” 설계된 모델입니다.
- 포지션: 구글의 새 최상위 프론티어 모델 (Flash 계열 위에 위치)
- 강점 영역: 코딩, 법률·금융 같은 지식 업무, 사이버 보안 방어, 창작
- 출력 한도: 64K → 100만 토큰 (업계 최대)
- 현재 접근: Fairwind Program의 검증된 사이버 방어자 + 구글 내부 팀 한정
- 다음 순서: 유료 API 고객 → Google AI Ultra 구독자 → 기업·일반 소비자
툴시 도시(Tulsee Doshi) 구글 딥마인드 Gemini 제품 총괄은 Axios 인터뷰에서 “Argon은 여러 영역에서 프론티어급 능력을 갖춘 균형 잡힌 모델”이라며 “최근 몇 주간 구글러들이 가장 어려운 코딩·리서치 문제에 이 모델을 활용해 왔다”고 밝혔습니다.
핵심 업그레이드 1: 출력 100만 토큰이 바꾸는 것
스펙 중에서 개발자에게 가장 체감될 변화는 출력 한도입니다. 이전 Gemini 모델들의 출력 상한은 64K 토큰이었어요. Argon은 이걸 100만 토큰으로 15배 이상 끌어올렸습니다.
“출력이 길어져서 뭐가 좋냐”고 생각할 수 있지만, 에이전틱 코딩에서는 이게 결정적입니다. 모델이 한 번의 실행(trajectory) 안에서 수십만 토큰을 생각하고 쓸 수 있다는 건 —
- 큰 모듈 하나를 잘게 쪼개지 않고 한 번에 재작성할 수 있고,
- 긴 보고서나 문서 뭉치를 중간 요약 없이 단일 패스로 초안 작성할 수 있으며,
- 복잡한 문제를 단계로 나누다 생기는 컨텍스트 유실 없이 끝까지 풀 수 있다는 뜻입니다.
구글 공식 발표문도 같은 취지를 강조합니다. “모델이 깊이 생각하고 단일 트랙에서 수십만 토큰을 생성할 여유(headroom)를 가지면, 어려운 문제를 한 번에 푸는 추론의 깊이가 새로워진다.” 다만 주의할 점도 있어요. 100만 출력 토큰을 실제로 채우면 출력 요금만 $10입니다. 긴 출력은 성능이자 비용이라는 것, 아래 가격 섹션에서 다시 다루겠습니다.
핵심 업그레이드 2: 벤치마크 — 진짜 1위 맞나?
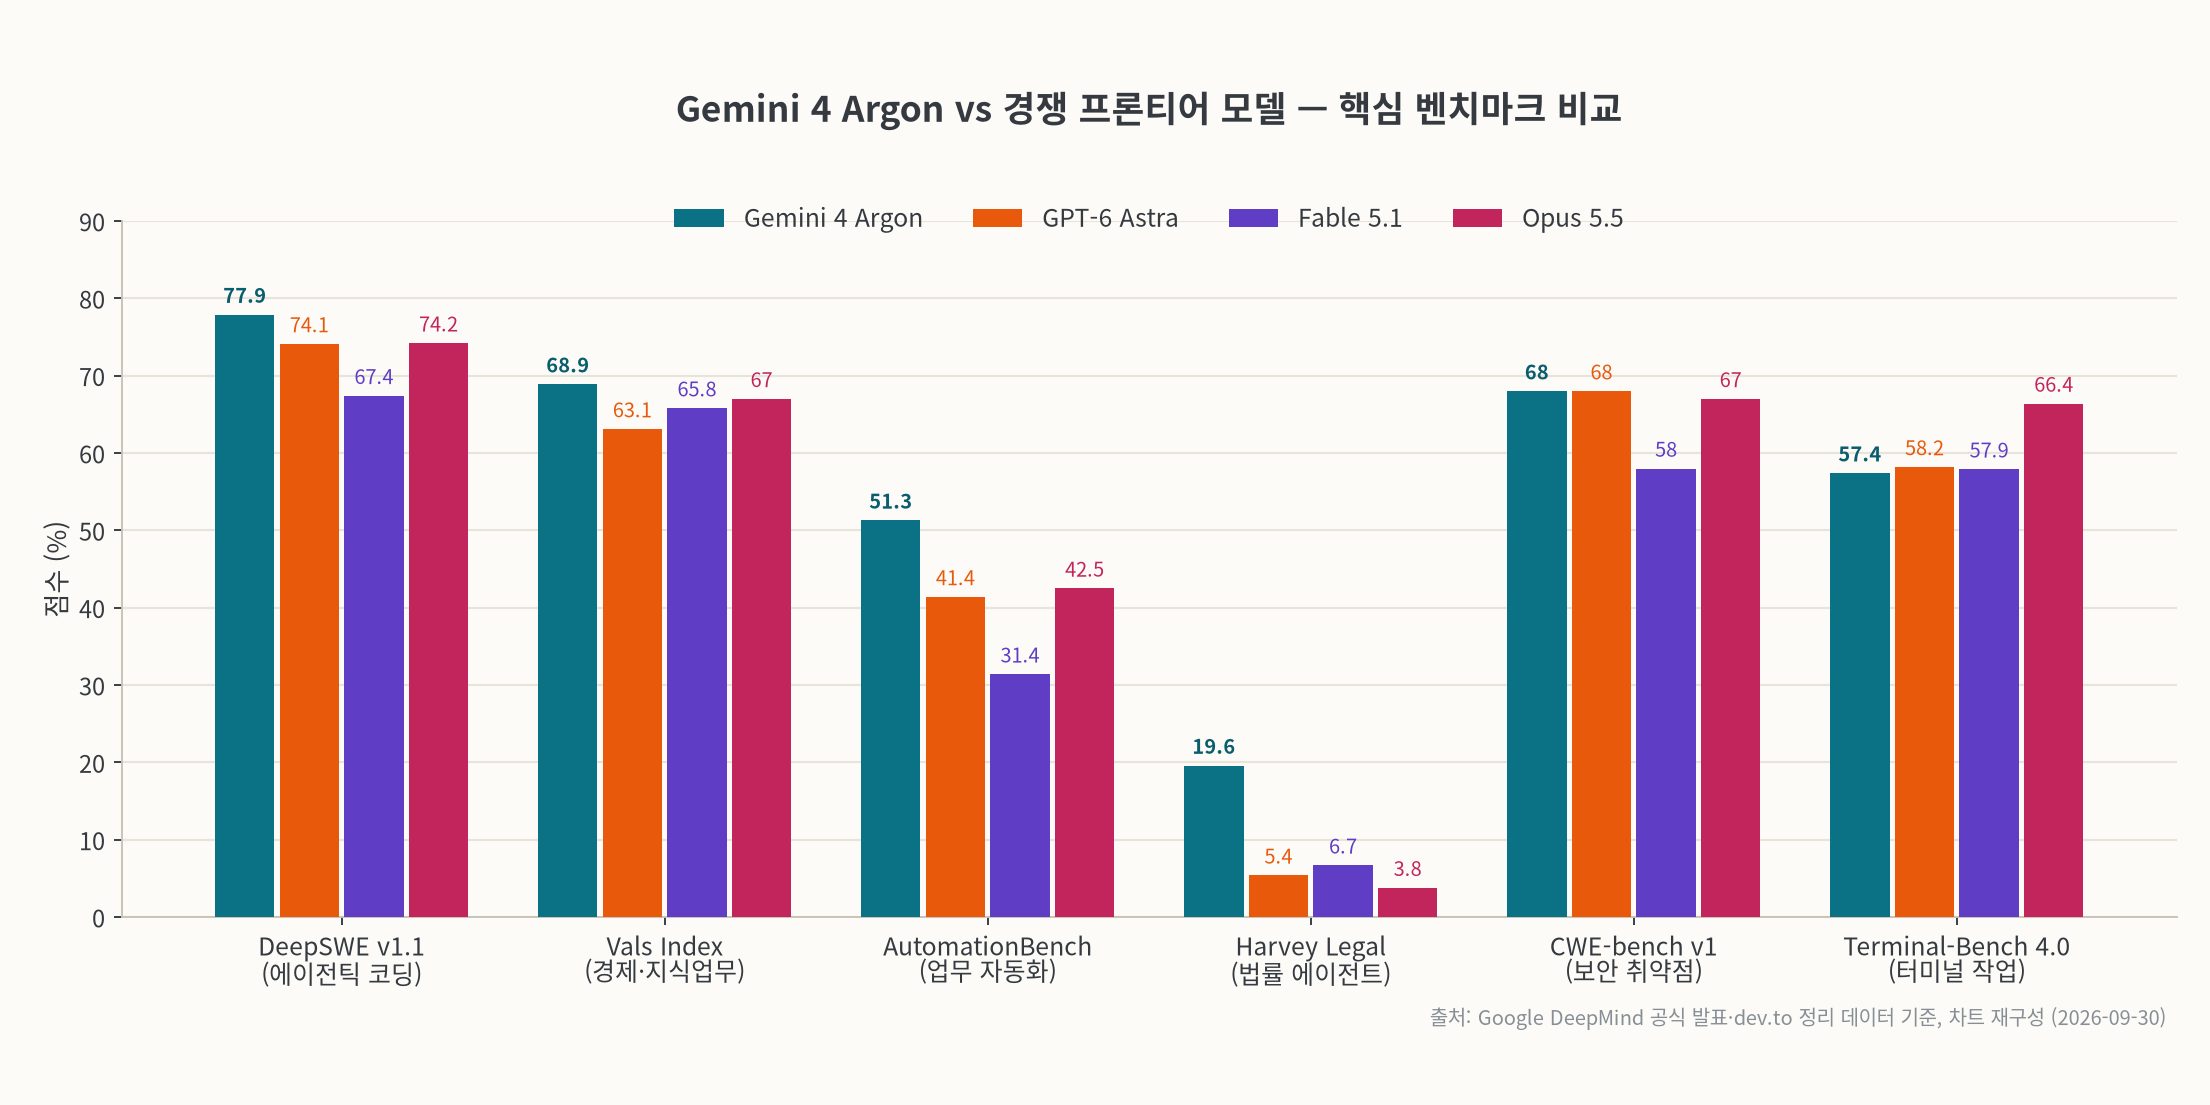
구글이 발표한 벤치마크를 경쟁 모델과 나란히 놓으면 Argon의 강점과 약점이 명확해집니다. 먼저 차트로 보시죠.
| 벤치마크 | Gemini 4 Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 (장기 코딩) | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index (경제 파급력) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench (업무 자동화) | 51.3% | 41.4% | 31.4% | 42.5% |
| Harvey Legal (법률 에이전트) | 19.6% | 5.4% | 6.7% | 3.8% |
| Vals Finance Agent v2 (금융) | 65.4% | 53.5% | 58.9% | 58.6% |
| CWE-bench v1 (취약점 패치) | 68.0% (공동 1위) | 68.0% | 58.0% | 67.0% |
| LVBench (장시간 비디오) | 91.7% | 87.5% | 79.7% | 83.7% |
| Terminal-Bench 4.0 (터미널) | 57.4% | 58.2% | 57.9% | 66.4% |
| FrontierSWE v2 (에이전틱 코딩) | 55.0% | 65.5% | 56.3% | 62.3% |
표에서 읽히는 결론은 세 가지입니다.
- ‘실제 업무’ 벤치마크에서는 압도적. 실제 소프트웨어 저장소를 대상으로 하는 DeepSWE v1.1에서 77.9%로 신기록을 세웠고, 미국의 GDP 비중으로 금융·코딩·법률 성적을 가중 평균하는 Vals Index에서도 1위입니다. 특히 법률 에이전트 벤치마크(Harvey)는 19.6% 대 경쟁 모델 3~6%대로 격차가 큽니다. 절대 점수는 낮아 보여도, 이 벤치마크 자체가 어렵기로 유명해서 상대 격차가 의미 있어요.
- 터미널·단순 코딩 최강자는 아님. Terminal-Bench 4.0(57.4%)과 FrontierSWE v2(55.0%)에서는 각각 Opus 5.5(66.4%)와 GPT-6 Astra(65.5%)에 뒤집니다. “코딩 1위”라는 표현은 벤치마크를 골라 말해야 성립하는 셈이죠.
- 멀티모달·장문 처리는 확실한 우위. 장시간 비디오 이해(LVBench 91.7%)와 256K~1M 토큰 장문 처리(GraphWalks 84.2%)는 경쟁 모델을 크게 앞섭니다. 1M 출력 한도와 맞물리는 지점입니다.
여러분이 지금 코딩 에이전트를 고르는 중이라면, “어떤 종류의 코딩이냐”가 Argon 채택 여부의 갈림길이 될 겁니다. 대규모 리팩토링·마이그레이션이라면 기대해볼 만하고, 짧은 터미널 작업 루프라면 기존 모델로도 충분해요.
핵심 업그레이드 3: 사이버 보안 — 가드레일을 ‘일부러’ 푼 모델
이번 출시에서 가장 특이한 지점은 보안입니다. 구글은 Argon을 “자율적으로 취약점을 찾고, 검증하고, 패치까지 하는” 방어용 사이버 모델로 훈련했다고 밝혔어요. 그리고 Fairwind Program의 신뢰받는 방어자와 구글 내부 팀에게는 사이버 가드레일 없이 모델을 제공합니다. 방어 목적의 취약점 연구에서는 가드레일이 오히려 성능을 깎아먹기 때문이죠.
실제 성과도 공개됐습니다. 보안 기업 Wiz가 Argon을 활용해 전 세계 병원에서 쓰는 의료 소프트웨어의 치명적 취약점을 발견했어요. 기존 프론티어 모델들이 놓쳤던, 환자 개인정보가 노출될 수 있는 수준의 위험이었다고 합니다. CWE-bench v1(취약점 패치 능력)에서는 GPT-6 Astra와 공동 1위(68%)를 기록했고, 구글은 지난달 나온 3.8 Flash Cyber 대비 취약점 발견 능력이 크게 도약했다고 설명합니다.
구글 내부에선 이미 ‘일하는 중’ — 공개된 실적 3가지
Argon의 실전 감각을 보여주는 건 벤치마크보다 구글 내부 사용 사례일지도 모릅니다. 공식 발표에 나온 세 가지가 인상적이에요.
- 데이터센터 메모리 300 TiB 확보: Argon 에이전트 팀이 구글 전체 함대의 프로파일링 텔레메트리를 분석해 메모리 최적화를 자율 적용했고, 그 결과 하드웨어 추가 구매 없이 300 TiB 이상의 메모리를 확보했습니다. 구글은 총 절감 효과가 500 TiB~1 PiB에 이를 것으로 추산해요.
- C/C++ → Rust 대규모 마이그레이션: re2, libgav1 같은 핵심 라이브러리 수만 줄부터 Fuchsia OS Zircon 커널 80만 줄 이상까지 Rust 전환을 진행 중입니다. 특히 비디오 디코더 libgav1에서는 SIMD 코드 3.2만 줄을 프로파일링 기반 실험을 반복해 대체했는데, 결과물이 기존 Rust 포트보다 2.7배 빠르면서 메모리 안전성까지 갖춘 디코더라고 해요. 영상 출력은 완전히 동일합니다.
- 양자 알고리즘 최적화: 양자 컴퓨팅 연구에서 큐빗×게이트 자원을 최적화해, 한 사례에서는 수 분 만에 논문 발표 기준선을 40% 개선했습니다.
물론 이런 수치는 모두 구글 자체 발표라는 점을 감안해야 합니다. 외부 검증이 끝난 숫자는 아니에요. 다만 “모델이 내부에서 실제 생산 업무에 투입됐다”는 사실 자체는 이전 세대 출시와는 확실히 다른 신호입니다.
가격: 도입가 기준 Opus 5.5의 절반
아직 일반 제공 전이지만 API 가격은 확정 발표됐습니다. 도입 기간(introductory) 한정 가격이라는 단서가 붙어요.
| 100만 토큰당 | Gemini 4 Argon (도입가) | Argon (정가 전환 후) | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| 입력 | $2 | $4 | $4 | $10 |
| 출력 | $10 | $20 | $20 | $50 |
| 캐시 입력 | $0.10 (95% 할인) | $0.20 | $0.20 | — |
핵심은 세 가지예요.
- 도입 기간에는 Opus 5.5의 정확히 절반, Astra 대비 1/5 가격입니다. 정가로 전환돼도 Opus 5.5와 동률, Astra보다는 쌉니다.
- 캐시 입력 95% 할인($0.10/M)은 반복 컨텍스트가 많은 에이전트 워크로드에서 실질 비용을 크게 낮춰줘요.
- 반면 출력 1M 토큰을 채우는 긴 작업은 출력료만 $10(도입가)입니다. 1M 출력이 열리는 만큼 출력 길이 상한을 앱 단에서 걸어두는 게 비용 방어에 중요합니다.
예를 들어 입력 1M + 출력 200K 토큰짜리 작업 1회는 Argon 도입가 기준 $4, Opus 5.5에서는 $8, Astra에서는 $20이 됩니다.
출시 일정: 왜 ‘단계적’인가
이제 처음 질문으로 돌아올 차례입니다. 왜 1위 모델을 바로 못 쓰게 했을까요. 구글의 공식 설명은 “이 규모와 능력의 프론티어 모델은 단계적 출시가 필요하다”는 것이에요. 순서는 이렇습니다.
- 현재: Fairwind Program의 검증된 사이버 방어자 + 구글 내부 — 사이버 가드레일 해제 상태로 방어 연구에 투입
- 동시에: 미국 정부의 자발적 사전 공개(pre-release) 검토 프로세스 참여 중
- 다음: 유료 API 고객 + Google AI Ultra 구독자부터 일반 제공 — 구체적인 날짜는 미정
- 이후: 기업·소비자 대상 확대
가드레일 없는 모델을 먼저 푸는 대신, 구글은 남용 방지를 위한 안전장치를 여러 겹 걸었다고 강조합니다. 공식 발표문에 나온 장치만 네 가지예요.
- 오남용 방어: 사이버·CBRN(화학·생물·방사선·핵) 공격 목적 요청은 거부하되, 정당한 이중용도(dual-use) 과학 연구는 보존. 모델 내부 활성화를 감시해 오남용 징후를 포착하는 기법을 개선했습니다.
- 프롬프트 인젝션 내성: 간접 프롬프트 인젝션(문서·웹페이지에 숨긴 악성 지시로 모델을 조종하는 공격)에 대해 “가장 회복력 있는 모델”을 주장하며, Gray Swan의 IPI 벤치마크에서 1위를 기록했다고 밝혔어요. 에이전트를 실제 업무에 붙일 기업에게는 이 항목이 가장 실질적입니다.
- 샌드박스 강화: 고위험 훈련·평가는 격리·봉인된 환경에서만 실행.
- 오정렬(misalignment) 감시: Argon의 사고 과정(chain-of-thought)과 행동을 실시간 감시하다가 사용자 의도를 벗어나려 하면 실행을 중단시키는 완화 장치를 운용합니다. 감시 결과가 다시 훈련에 피드백되지 않게 분리해, 모델이 ‘감시를 우회하는 법’을 배우지 않도록 설계했다고 해요.
에디터가 직접 확인한 점
이 글은 모델이 아직 공개 전이라 직접 사용 테스트는 불가능했고, 대신 공식 발표문 원문과 외신 4곳(Ars Technica, CNBC, 9to5Google, Axios), 서드파티 벤치마크 정리(dev.to, vals.ai, testingcatalog)를 교차 대조해 검증했습니다. 그 과정에서 눈에 띈 점은 —
- 구글은 “코딩 1위”를 DeepSWE v1.1 기준으로 말하는데, Terminal-Bench 4.0과 FrontierSWE v2에서는 각각 Opus 5.5와 Astra가 앞선다는 사실이 공식 발표에서는 강조되지 않습니다. 벤치마크 선택에 따른 프레이밍은 어느 벤더 발표에서나 확인이 필요해요.
- 가격의 “introductory” 조건(언제 정가로 전환되는지)은 발표문에 기한이 명시되지 않았습니다. 예산 계획 시 이 불확실성을 반영하는 게 안전합니다.
- 300 TiB, 2.7배 같은 내부 성과 수치는 전부 구글 자체 발표로, 아직 외부 검증 논문이나 제3자 확인은 없는 상태입니다.
실무 체크리스트 — Argon 출시 후 준비 사항
- ☐ 지금 운영 중인 AI 기능의 토큰 사용 패턴을 점검했는가 (입력/출력 비율, 캐시 활용 가능 여부)
- ☐ 출력 길이 상한을 앱 설정으로 걸어 1M 출력 비용 폭탄을 방어했는가
- ☐ 우리 워크로드가 Argon의 강점 영역(장기 코딩, 문서 기반 지식 업무, 멀티모달)인지 약점 영역(짧은 터미널 루프)인지 판단했는가
- ☐ Google AI Ultra 구독 또는 유료 API 계정 상태 — 일반 제공 시 첫 번째 물결에 들어갈 준비가 됐는가
- ☐ 에이전트를 외부 문서·웹과 연결할 계획이라면 프롬프트 인젝션 방어 계층(입력 살균, 권한 최소화)을 점검했는가
- ☐ 기존 Gemini 3.x 계열 코드에 Argon 전환 시 호출 규격 변경점(출력 한도, 가격 티어)을 반영할 계획이 있는가
FAQ
Q1. 지금 당장 Gemini 4 Argon을 써볼 수 있는 방법은 없나요?
공식 경로는 없습니다. 현재는 Fairwind Program의 검증된 사이버 방어자와 구글 내부 팀만 접근 가능해요. 이후 유료 API 고객과 Google AI Ultra 구독자부터 열리는데, 구글은 구체적인 날짜를 약속하지 않았습니다. “Argon 무료 체험”을 내세우는 사이트는 사칭일 가능성이 높으니 주의하세요.
Q2. Gemini 3.5 Pro는 결국 어떻게 된 건가요?
취소됐습니다. 6월에 예고됐던 3.5 Pro는 나오지 않았고, 구글은 여름 동안 3.8 Flash 계열에 집중한 뒤 이번 Argon으로 세대 번호를 4로 올리며 새 네이밍(버전 + 원소 이름)을 도입했어요.
Q3. 도입가 $2/$10은 언제까지 유지되나요?
공식 발표문에 종료 시점이 명시되지 않았습니다. 도입 기간이 끝나면 입력 $4 / 출력 $20(100만 토큰당)로 전환된다는 점만 확정이에요. 장기 예산은 정가 기준으로 짜두는 게 안전합니다.
Q4. 코딩용으로 Argon이 Opus 5.5나 Astra보다 확실히 좋다고 할 수 있나요?
벤치마크에 따라 다릅니다. 대규모 실제 저장소 작업(DeepSWE v1.1)에서는 Argon이 77.9%로 1위지만, 터미널 중심 작업(Terminal-Bench 4.0)에서는 Opus 5.5(66.4%)가, FrontierSWE v2에서는 Astra(65.5%)가 앞섭니다. 자기 워크로드와 닮은 벤치마크로 판단하는 게 맞아요.
Q5. ‘가드레일 없는 버전’이 있다는 게 위험하지 않나요?
구글은 이 버전을 검증된 방어자(Fairwind Program 참가자)와 내부 팀에만 제한 제공하며, 미국 정부 사전 공개 프로세스에도 참여하고 있다고 밝혔습니다. 악성 코드·취약점 연구처럼 정당한 방어 목적 작업에서 가드레일이 오히려 방해가 되기 때문이라는 설명이에요. 일반 제공 버전에는 표준 안전장치가 적용됩니다.
결론 — 기다릴 가치가 있는 1위인가
Gemini 4 Argon은 “모든 벤치마크 1위” 모델은 아닙니다. 터미널 코딩에서는 Opus 5.5가, FrontierSWE에서는 Astra가 여전히 앞서요. 하지만 실제 저장소 수준의 장기 코딩, 법률·금융 지식 업무, 장문·멀티모달 처리라는 ‘돈이 되는 영역’에서는 현재 가장 강한 성적표를 들고 나왔고, 도입가는 Opus 5.5의 절반입니다. 1M 출력 토큰과 캐시 95% 할인은 에이전트 워크로드의 경제성 자체를 바꿀 잠재력이 있어요.
단계적 출시는 답답하지만, 가드레일 해제 버전을 먼저 보안 방어에 투입하고 정부 검토를 거치는 방식 자체가 프론티어 모델 출시의 새 표준이 되어가고 있습니다. 지금 할 수 있는 준비는 명확해요 — 토큰 사용 패턴 점검, 유료 API·AI Ultra 계정 준비, 그리고 자기 워크로드에 맞는 벤치마크로 Argon을 평가할 기준을 미리 세워두는 것. 일반 제공이 열리는 대로 Apptics에서 실사용 후기로 다시 정리해 드리겠습니다.
함께 읽으면 좋은 글
- Gemini 3.8 Flash 출시: Opus 5급 코딩을 7분의 1 가격에
- Claude Opus 5.5 출시: 개발자가 오늘 고쳐야 할 것들
- GPT-6.1 Sol 일주일 만의 교체: Astra급 지능을 1/5 가격에
- MiMo-V2.6 오픈웨이트 공개: 1/20 가격으로 오픈소스 1위를 바꾸다