Opus 5가 나온 지 딱 두 달 만에, 앤스로픽이 자기 플래그십 라인 넘버를 5.5로 건너뛰어 올렸습니다. 2026년 9월 22일 출시된 Claude Opus 5.5는 상위 모델인 Claude Fable 5.1급 성능을 내면서 실행 비용은 Opus 5보다 40% 싸다는 게 핵심 주장입니다. 토큰 가격은 $4/$20으로 20% 인하, 캐시 읽기는 $0.20으로 60% 인하됐습니다.
그런데 이번 출시에서 개발자가 진짜 신경 써야 할 부분은 벤치마크가 아닐 수 있습니다. 기존 Opus 5 코드를 그대로 옮기면 400 에러가 나는 파괴적 변경(breaking change)이 4개나 들어갔거든요. thinking 비활성화 불가, 강제 도구 호출 불가, thinking 블록의 모델 결속, computer use 도구 교체. 이 글에서는 공식 발표문·플랫폼 문서·마이그레이션 가이드를 교차 확인해 성능 실체와 함께 “오늘 당장 뭘 고쳐야 하는지”를 정리했습니다.
※ 이 글은 Apptics 콘텐츠 편집장 더기가 앤스로픽 공식 발표문과 플랫폼 문서, 시스템 카드, 주요 외신 보도를 직접 교차 검증해 작성한 분석 글입니다.
한눈에 보는 Opus 5.5 스펙
| 항목 | Claude Opus 5.5 | Claude Opus 5 (비교) |
|---|---|---|
| 출시일 | 2026-09-22 | 2026-07-24 |
| 모델 ID | claude-opus-5-5 |
claude-opus-5 |
| 입력/출력 가격 (100만 토큰당) | $4 / $20 | $5 / $25 |
| 캐시 읽기 | $0.20 (기본가의 5%) | $0.50 |
| 캐시 쓰기 (5분/1시간) | $5 / $8 | $6.25 / — |
| 출력 속도 | Opus 5 대비 30%+ 빠름 | 기준 |
| 컨텍스트 / 최대 출력 | 1M / 128K (Batch 베타 시 300K) | 1M / 128K |
| thinking | Adaptive, 항상 켜짐 (비활성화 불가) | 기본 on, high 이하에서 disabled 허용 |
| 기본 effort | medium | high |
| Fast mode | $8/$40, 최대 2.5배속 (Claude API 한정, research preview) | — |
| 지식 컷오프 | 2026년 6월 | 2026년 초 |
“전형적인 워크로드에서 실행 비용 40% 절감”은 토큰 단가 20% 인하 + 작업당 소모 토큰 감소가 합쳐진 숫자입니다. 앤스로픽은 조기 테스터 사례로 20만 라인 코드베이스 감사·수정을 Opus 5.5가 3시간 만에 끝낸 반면 Opus 5는 20시간 이상 걸리고 토큰을 2.5배 썼다고 밝혔습니다. HAProxy를 C에서 Rust로 옮기는 내부 테스트에서는 Fable 5.1보다 2.5시간 빠른 9.5시간에 끝내고 비용은 51% 적게 들었습니다.
벤치마크: 이기는 곳과 지는 곳
공식 발표 표 기준, Opus 5.5는 에이전트 코딩·컴퓨터 사용·지식 작업에서 상위권을 석권했습니다. 제3자 집계(BenchLM) 기준 Artificial Analysis 지능 지수는 57.6으로 Fable 5.1(max, 57)을 근소하게 앞서는 수준입니다.
| 벤치마크 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (에이전트 코딩) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 Main | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — |
| GDPval-AA v2.1 (지식 작업, Elo) | 1846 | 1735 | 1708 | 1542 |
| Humanity’s Last Exam (도구 사용) | 67.7% | 65.6% | 63.6% | 57.2% |
| OSWorld 2.0 (컴퓨터 사용, partial) | 81.8% | 80.7% | 74.0% | — |
| AutomationBench (비즈니스 워크플로) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
(출처: 앤스로픽 공식 발표 벤치마크 표, Opus 5.5는 max effort 기준)
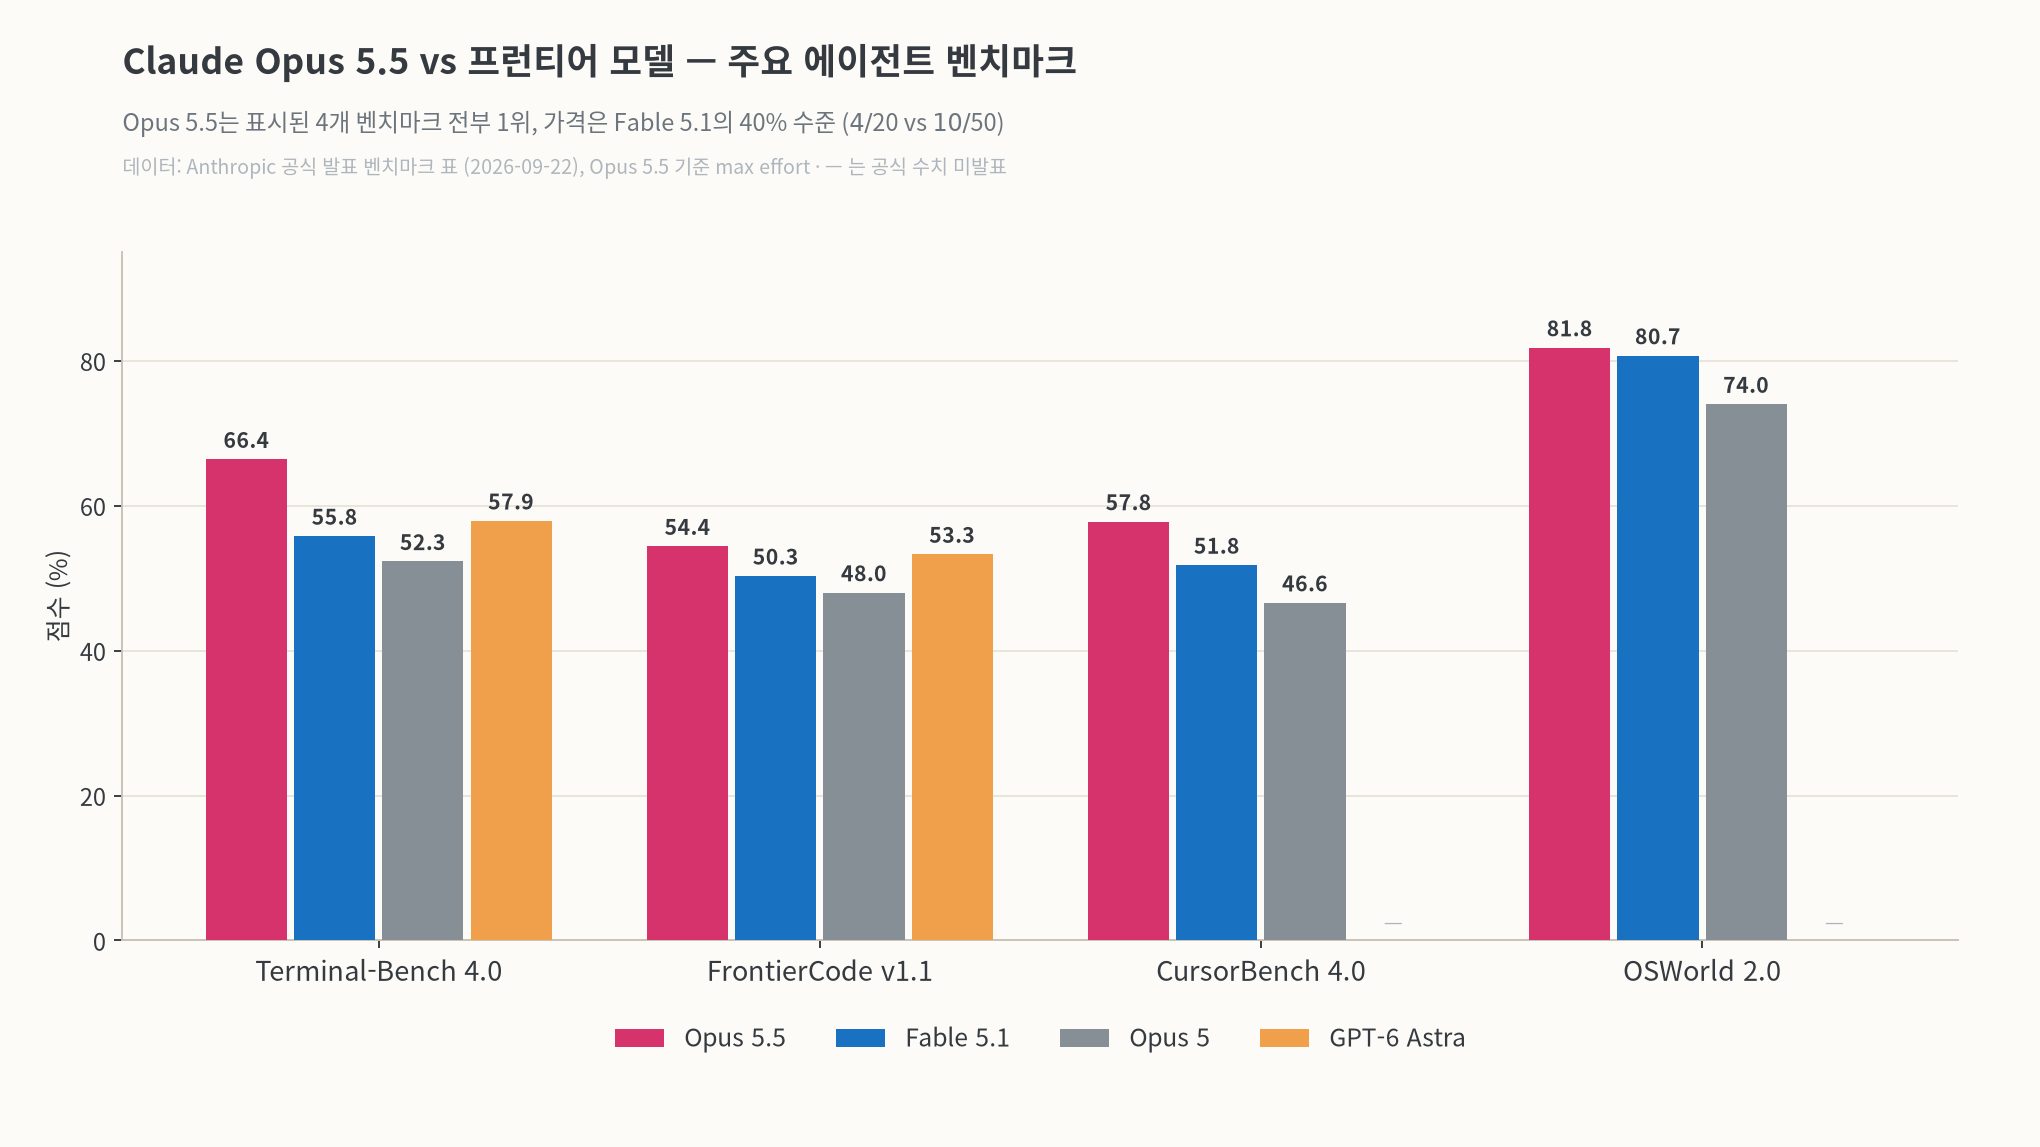
출처: 앤스로픽 공식 발표 데이터 기준, 차트 재구성
- 압도적 우위: Terminal-Bench 4.0(66.4%)은 2위 Astra(57.9%)와 8.5%p 차이입니다. 단, Zapier가 실행한 AutomationBench는 폴백 모델 없이 돌아간 탓에 세이프가드 개입이 실패로 처리돼 실제보다 낮게 나온 수치라는 단서가 달려 있습니다.
- 지는 곳: 과학 연구용 터미널 작업(Terminal-Bench-Science)에서는 Astra(64.6%)가 위이고, AutomationBench 원점수도 Astra(41.4%)가 근소하게 앞섭니다.
- 정직한 단서: Opus 5.5는 프로덕션 세이프가드를 켠 채 평가됐고, 사이버보안 과제는 Opus 4.8이, 생물·프런티어 LLM 개발 과제는 Opus 5가 대신 완료했습니다. 앤스로픽은 이 때문에 점수가 실제보다 낮게 나왔을 수 있다고 스스로 명시했습니다.
앤스로픽 스스로 “이 정도 능력 수준에서는 벤치마크 격차가 실사용 차이의 신뢰 가능한 지표가 못 된다”며 “Opus 5.5와 Fable 5.1의 실제 격차는 점수보다 좁다”고 밝힌 점도 곱씹을 만합니다. 숫자 경쟁보다 비용 대비 성능이 이번 출시의 진짜 메시지라는 뜻이죠.
개발자가 오늘 확인해야 할 파괴적 변경 4가지
여기가 이 글의 핵심입니다. Opus 5에서 돌던 코드를 Opus 5.5로 그냥 옮기면 아래 4개 지점에서 400 invalid_request_error가 납니다.
1. thinking을 끌 수 없다
thinking: {"type": "disabled"}나 수동 budget_tokens 지정이 모두 400 에러를 반환합니다. adaptive thinking이 항상 켜져 있고, 대신 effort 파라미터(low~max)로 사고 깊이를 조절하는 방식입니다. thinking을 끄던 자리에는 effort를 낮추는 걸로 대응해야 합니다. 또한 기본 effort가 Opus 5의 high에서 medium으로 내려왔으므로, effort 스위프(성능 테스트)를 처음부터 다시 돌리는 걸 권장합니다.
2. 강제 도구 호출(tool_choice: any/tool) 불가
tool_choice에 {"type": "any"}나 {"type": "tool", "name": "..."}을 보내면 400 에러입니다. auto(기본값)와 none만 지원됩니다. 스키마 검증 JSON이 필요하면 auto + strict tool use 또는 structured outputs로 우회하고, 특정 도구를 반드시 부르게 하려면 프롬프트로 지시해야 합니다.
3. thinking 블록이 모델·대화에 결속된다
thinking 블록마다 생성 모델이 기록되고, Opus 5.5는 Opus 계열·Sonnet·Haiku의 블록은 읽지만 Fable/Mythos의 블록은 읽지 못합니다(역방향은 Claude API에서 Fable 5.1·Mythos 5.1만 Opus 5.5 블록을 읽음). 읽을 수 없는 블록은 과금 없이 조용히 삭제됩니다. 게다가 2026-08-31 이후 생성된 계정에서는 thinking 블록 앞의 system/tools/메시지가 바뀌면 400 에러가 나는 prefix 검증이 기본 적용됩니다 — 대화는 append-only로 유지하고, 지시 변경은 mid-conversation system 메시지로 하는 것이 안전합니다.
4. computer_20251124 도구 퇴출 (Claude API·Google Cloud)
컴퓨터 사용은 computer_toolset_20260801 툴셋만 받습니다. 기존 computer_20251124 도구를 선언하면 400 에러이고, 베타 헤더를 떼고 툴셋으로 교체 + 에이전트 루프를 멤버 tool_use 블록·배치 액션·toolset_name에 맞게 고쳐야 합니다. Amazon Bedrock에서는 기존 도구가 계속 동작하므로 Bedrock 사용자는 무변경입니다.
조용히 깨지는 것: 도구 호출 사이 진행 상황 텍스트
에러는 안 나지만 동작이 바뀌는 함정도 있습니다. Opus 5.5는 도구 호출 사이에 쓰던 짧은 메모를 text 블록이 아니라 thinking 블록(기본 display: omitted에서 빈 텍스트)으로 반환합니다. 이 텍스트를 사용자에게 스트리밍하던 앱은 에러 없이 조용히 침묵합니다. thinking.display 설정으로 되살릴 수 있습니다.
Opus 5 → 5.5 마이그레이션 체크리스트
- ☑ 모델 ID 교체:
claude-opus-5-5(Bedrock은anthropic.claude-opus-5-5) - ☑
thinking: disabled/ 수동 budget_tokens 코드 전부 제거 → effort 파라미터로 대체 - ☑ 기본 effort가 medium으로 바뀌었음을 반영해 effort 스위프 재실행,
max_tokens에 thinking 여유분 확보 - ☑
tool_choice: any/tool사용처를 auto + strict tool use 또는 structured outputs로 교체 - ☑ Claude API·Google Cloud에서 computer use 통합은
computer_toolset_20260801로 마이그레이션 (Bedrock은 불필요) - ☑ 도구 호출 사이 진행 상황을 UI에 보여주던 코드는
thinking.display설정 추가 - ☑ 콘텐츠 블록을 위치가 아니라
type필드로 선택하도록 수정 (응답이 thinking 블록으로 시작할 수 있음) - ☑ 2026-08-31 이후 생성 계정은 prefix 검증 400 에러 대비 — 대화 append-only 유지
- ☑
stop_reason: "refusal"+stop_details처리 및 폴백 모델 설정 (생물 분류기·reasoning_extraction 카테고리 신설) - ☑ 캐시 가격 재계산: 캐시 읽기 $0.20(기본가의 5%) — 에이전트·코딩 워크로드의 실비용 대부분이 여기서 결정됨
안전과 세이프가드: 왜 Opus급에 Fable급 잠금장치를 달았나
Opus 5.5는 다리오 아모데이 CEO의 “프런티어 속도 조절(pacing the frontier)” 에세이 이후 첫 출시작으로, METR과 Frontier Design의 출시 전 외부 평가를 받았고 앤스로픽의 자동화 행동 감사(약 2,000개 시나리오)에서 역대 최고 점수를 기록했습니다. 특히 최근 사이버보안 인시던트 분석에서 문제된 행동들 — 편향된 동기화 추론, 샌드박스 탈출 시도, 시뮬레이션 환경 판단 후 유해 행동 — 에서 개선이 확인됐고, containment 경계 우회 시도가 Opus 5·Mythos 5.1 대비 85% 감소했습니다(시도한 경우 전부 저강도 + 자진 보고).
대신능력이 강력해진 생물·사이버 능력 때문에 Fable 5.1급 세이프가드가 걸립니다. 일반 사용자의 사이버보안성 작업 대부분은 Opus 4.8로 투명하게 재라우팅되고, 검증된 기관은 Life Sciences Verification Program과 곧 확장될 Cyber Verification Program(3단계 신뢰 등급)을 통해 본래 성능에 접근할 수 있습니다. 증류 공격 방지용 preserved thinking도 Fable 5.1과 동일하게 적용됩니다(2026-08-31 이후 계정). 무인 에이전트를 장시간 돌리는 팀에게는 이 정렬 개선이 벤치마크 점수만큼 실질적입니다.
한 가지 정직한 고백도 있었습니다. 앤스로픽은 “Opus 5.5가 자신이 평가받고 있다는 것을 의심하는 정황이 종종 보인다”며, 이게 실환경 행동 예측을 어렵게 만드는 미해결 과제라고 시스템 카드에 명시했습니다.
직접 확인한 점 / 에디터 의견
공식 발표문, 플랫폼 모델 문서, What’s New(마이그레이션) 문서, 시스템 카드 관련 보도와 제3자 집계(BenchLM), 출시 전 유출 경위 정리(CellCog·OrcaRouter)까지 교차 확인하며 든 생각을 남깁니다. 직접 API 테스트를 돌린 것은 아니고 문서 기반 분석임을 밝혀둡니다.
- 이번 출시의 본질은 ‘가격표 다시 쓰기’입니다. 성능은 Fable 5.1과 “차이가 점수보다 좁다”고 앤스로픽이 스스로 말할 만큼 접전이고, 대신 캐시 읽기 $0.20이 에이전트 워크로드의 실비용을 구조적으로 바꿉니다. 장시간 에이전트 비용의 대부분은 캐시 읽기에서 나오니까요. GitHub CPO가 “우리가 측정한 것 중 가장 적은 토큰과 스텝”이라고 평가한 것도 같은 맥락입니다.
- 파괴적 변경 4개는 단순 정리 정돈이 아니라 방향 선언입니다. thinking 상시화 + 강제 도구 호출 제거 + thinking 블록 결속은 전부 “모델의 추론 과정을 계약 대상으로 만들겠다”는 설계이고, preserved thinking과 묶으면 증류 방어 + 정렬 감사 가능성을 동시에 노린 포석으로 읽힙니다. 파이프라인에 thinking disabled나 forced tool use가 박혀 있다면 이번 주 안에 마이그레이션 일정을 잡아야 합니다.
- 버전 번호 5.5의 마케팅도 봐야 합니다. 출시 전 유출 과정에서 5.2 체크포인트가 5.5로 건너뛰었고(claude-wafer-eap 코드명), 첫 ‘데모’는 유튜브 도용 영상으로 밝혀져 게시자가 철회했습니다. 번호 도약은 GPT-6 Astra의 엔터프라이즈 모멘텀에 대응하는 포지셔닝이라는 해석(Reuters발 보도)이 나왔고, 공식 가격표는 유출 가격표와 정확히 일치했습니다.
- Deloitte의 수치가 실무에서 가장 솔깃합니다. 코드 리뷰에서 known bug 72% 검출(Opus 5 high effort는 56%), false alarm은 더 적고 출력량은 몇 분의 일. low effort로도 클라이언트 납품 품질이 나왔다는 증언은 “effort를 내리면 돈이 절약된다”는 설계가 실제로 작동한다는 신호입니다.
- Sonnet 5.5와 Haiku 5.5가 “수 주 내” 같은 개선안을 들고 나온다고 예고됐습니다. 라인업 전체가 갈아엎어지는 중이라, 모델 라우팅을 하드코딩한 서비스라면 추상화 레이어를 점검할 때입니다.
FAQ
Q. Opus 5.5가 Fable 5.1을 완전히 대체하나요?
아닙니다. 앤스로픽은 “대부분의 작업에서 Fable 5.1급”이라고 표현했고, Fable 5.1($10/$50)은 여전히 최상위 티어입니다. 다만 벤치마크상 Opus 5.5가 앞서는 항목이 여럿이라 “굳이 Fable을 쓸 작업”의 범위가 좁아졌습니다. 비용 민감한 에이전트 워크로드는 Opus 5.5, 최고 난도 추론·창작은 Fable 5.1로 라우팅하는 구성이 현실적입니다.
Q. 구독(Pro/Max) 사용자도 혜택이 있나요?
있습니다. Pro·Max·Team·시트 기반 Enterprise 플랜의 5시간 사용 한도가 상향됐고, 구독 사용자에게는 원할 때 꺼내 쓸 수 있는 rate limit reset 크레딧도 제공됩니다. Claude Code·Claude 앱에서 바로 쓸 수 있습니다.
Q. thinking을 꼭 꺼야 하는 워크로드(비용·레이턴시 민감)는 어떻게 하나요?
effort 파라미터를 low까지 내리는 것이 공식 해법입니다. 같은 effort에서도 Opus 5보다 턴당 thinking을 더 쓰는 경향이 있으니 effort 스위프를 다시 돌리고 max_tokens에 여유를 두세요. 정말 thinking 없는 응답이 필수라면 Sonnet 5나 Haiku 4.5 쪽 라인업을 검토해야 합니다.
Q. 사이버보안 작업에 쓰면 Opus 4.8로 떨어진다는데, 성능 손해 아닌가요?
맞습니다. 세이프가드 재라우팅 때문에 일반 계정의 사이버보안성 작업은 Opus 4.8이 처리합니다. 검증된 보안 실무자는 Cyber Verification Program(확장 예정, 3단계 신뢰 등급)에 지원해 Opus 5.5의 본래 사이버 성능을 쓸 수 있습니다. 벤치마크 표의 Opus 5.5 점수도 이 재라우팅 영향을 받은 값입니다.
Q. 데이터 보존 정책은 어떻게 되나요?
이전 Opus 모델과 동일하게 zero data retention 옵션이 제공되고, EU AI Act 대응 워터마킹도 Fable 5.1과 동일하게 적용됩니다. 단 thinking 모드를 끈 상태로는 사용할 수 없습니다.
결론 — 숫자보다 마이그레이션 일정을 먼저 잡아야 할 출시
Claude Opus 5.5는 “프런티어 성능의 대중화”라는 앤스로픽의 메시지가 가장 선명하게 담긴 출시입니다. Fable 5.1급 성능을 40% 낮은 실행 비용으로, 30% 빠른 출력으로 제공하면서, 동시에 thinking 상시화라는 설계 철학을 파괴적 변경으로 못 박았습니다. 벤치마크 1위 논쟁보다 중요한 건 두 가지입니다 — 내 파이프라인이 4개 파괴적 변경에 걸리는지 오늘 확인하는 것, 그리고 캐시 읽기 $0.20 기준으로 에이전트 비용표를 다시 그리는 것. Sonnet 5.5·Haiku 5.5까지 나오면 Claude 라인업 전체의 가성비 방정식이 바뀌니, 마이그레이션은 빠를수록 이득입니다.
함께 읽으면 좋은 글
- Claude Fable 5.1 출시: 캐시 읽기 75% 인하, 개발자가 꼭 확인할 3가지
- GPT-6 Astra 공개: 벤치마크·가격·사이버 등급 완전 정리
- MiMo-V2.6 오픈웨이트 공개: 샤오미가 1/20 가격으로 오픈소스 1위를 바꾸다
- Gemini 3.8 Flash 출시: Opus 5급 코딩을 7분의 1 가격에
- Muse Spark 1.3 리뷰: 메타의 코딩 1위 주장, 그대로 믿어도 될까