스마트폰과 전기차로 유명한 샤오미가, 클로즈드 프런티어 모델들 바로 아래 자리에 오픈웨이트 깃발을 꽂았습니다. 2026년 9월 21일 공개된 MiMo-V2.6-Pro는 Artificial Analysis 지능 지수 46점으로 GLM-5.3과 Kimi K3(44점)를 제치고 전 세계 오픈웨이트 모델 1위에 올랐고, 같은 날 나온 xAI의 Grok 4.7과 동점을 기록했습니다. 이전 세대 MiMo-V2.5-Pro가 26점이었으니 한 세대 만에 20점 상승입니다.
더 흥미로운 건 가격입니다. Pro는 입력 토큰 100만 개당 0.435달러, Flash는 0.14달러. 같은 성능대의 클로즈드 모델 대비 1/20~1/60 수준이고, 가중치는 MIT 라이선스로 누구나 무료로 내려받을 수 있습니다. 이 글에서는 공식 발표문과 기술 보고서, HuggingFace 모델 카드, 주요 외신 보도를 교차 확인해 Pro와 Flash의 차이점, 벤치마크 실체, 그리고 실무에서 어느 쪽을 써야 하는지 정리했습니다.
※ 이 글은 Apptics 콘텐츠 편집장 더기가 공식 문서와 10개 이상의 보도 자료를 직접 교차 검증해 작성한 분석 글입니다.
Pro와 Flash, 숫자로 보는 차이
두 모델은 같은 MiMo-V2.6 시리즈지만 체급이 완전히 다릅니다. 핵심 스펙을 먼저 비교해볼게요.
| 항목 | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| 총 파라미터 | 1.02조 (1.02T) | 3,090억 (309B) |
| 활성 파라미터 (토큰당) | 42B | 15B |
| 구조 | 스파스 MoE (384개 중 8개 라우팅) | 스파스 MoE (256개 중 8개 라우팅) |
| 컨텍스트 윈도우 | 1M 토큰 (1,048,576) | |
| 입력 방식 | 텍스트·이미지·오디오·비디오 (네이티브 옴니모달) | |
| API 가격 (입력/출력, 100만 토큰당) | $0.435 / $0.87 | $0.14 / $0.28 |
| AA 지능 지수 | 46.32 (오픈웨이트 1위) | 미발표 (Pro 근접) |
| 라이선스 | MIT (상업용·셀프호스팅·재배포 자유) | |
두 모델 모두 희소 혼합 전문가(MoE) 구조라 실제 추론 비용은 총 파라미터가 아니라 활성 파라미터에 비례합니다. 1조 파라미터 모델이라고 해도 토큰 하나를 만들 때 움직이는 건 42B뿐이라는 뜻이죠. 여기에 5층 멀티 토큰 예측(MTP) 디코더와 하이브리드 어텐션(슬라이딩 윈도우 + 글로벌)을 조합해 대형 모델인데도 Pro 기준 초당 약 134토큰의 출력 속도를 냅니다.
벤치마크: 진짜 1위인가, 부분 1위인가
샤오미는 “Pro가 대부분의 에이전트 벤치마크에서 Claude Opus 5, GPT-5.6 Sol과 대등하다”고 발표했습니다. 기술 보고서의 수치를 보면 이 주장은 절반은 맞고 절반은 과장입니다.
| 벤치마크 | MiMo-V2.6 Pro | MiMo-V2.6 Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 (코딩 에이전트) | 71.9 | 67.9 | 74.0 | 73.0 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 49.0 | 39.9 |
| ExploitBench (사이버) | 47.9 | 25.3 | 70.0 | 78.5 |
| CyberGym | 94.0 | 95.1 | – | – |
(출처: MiMo-V2.6 기술 보고서, 벤치마크 표 수치는 공식 발표 기준)
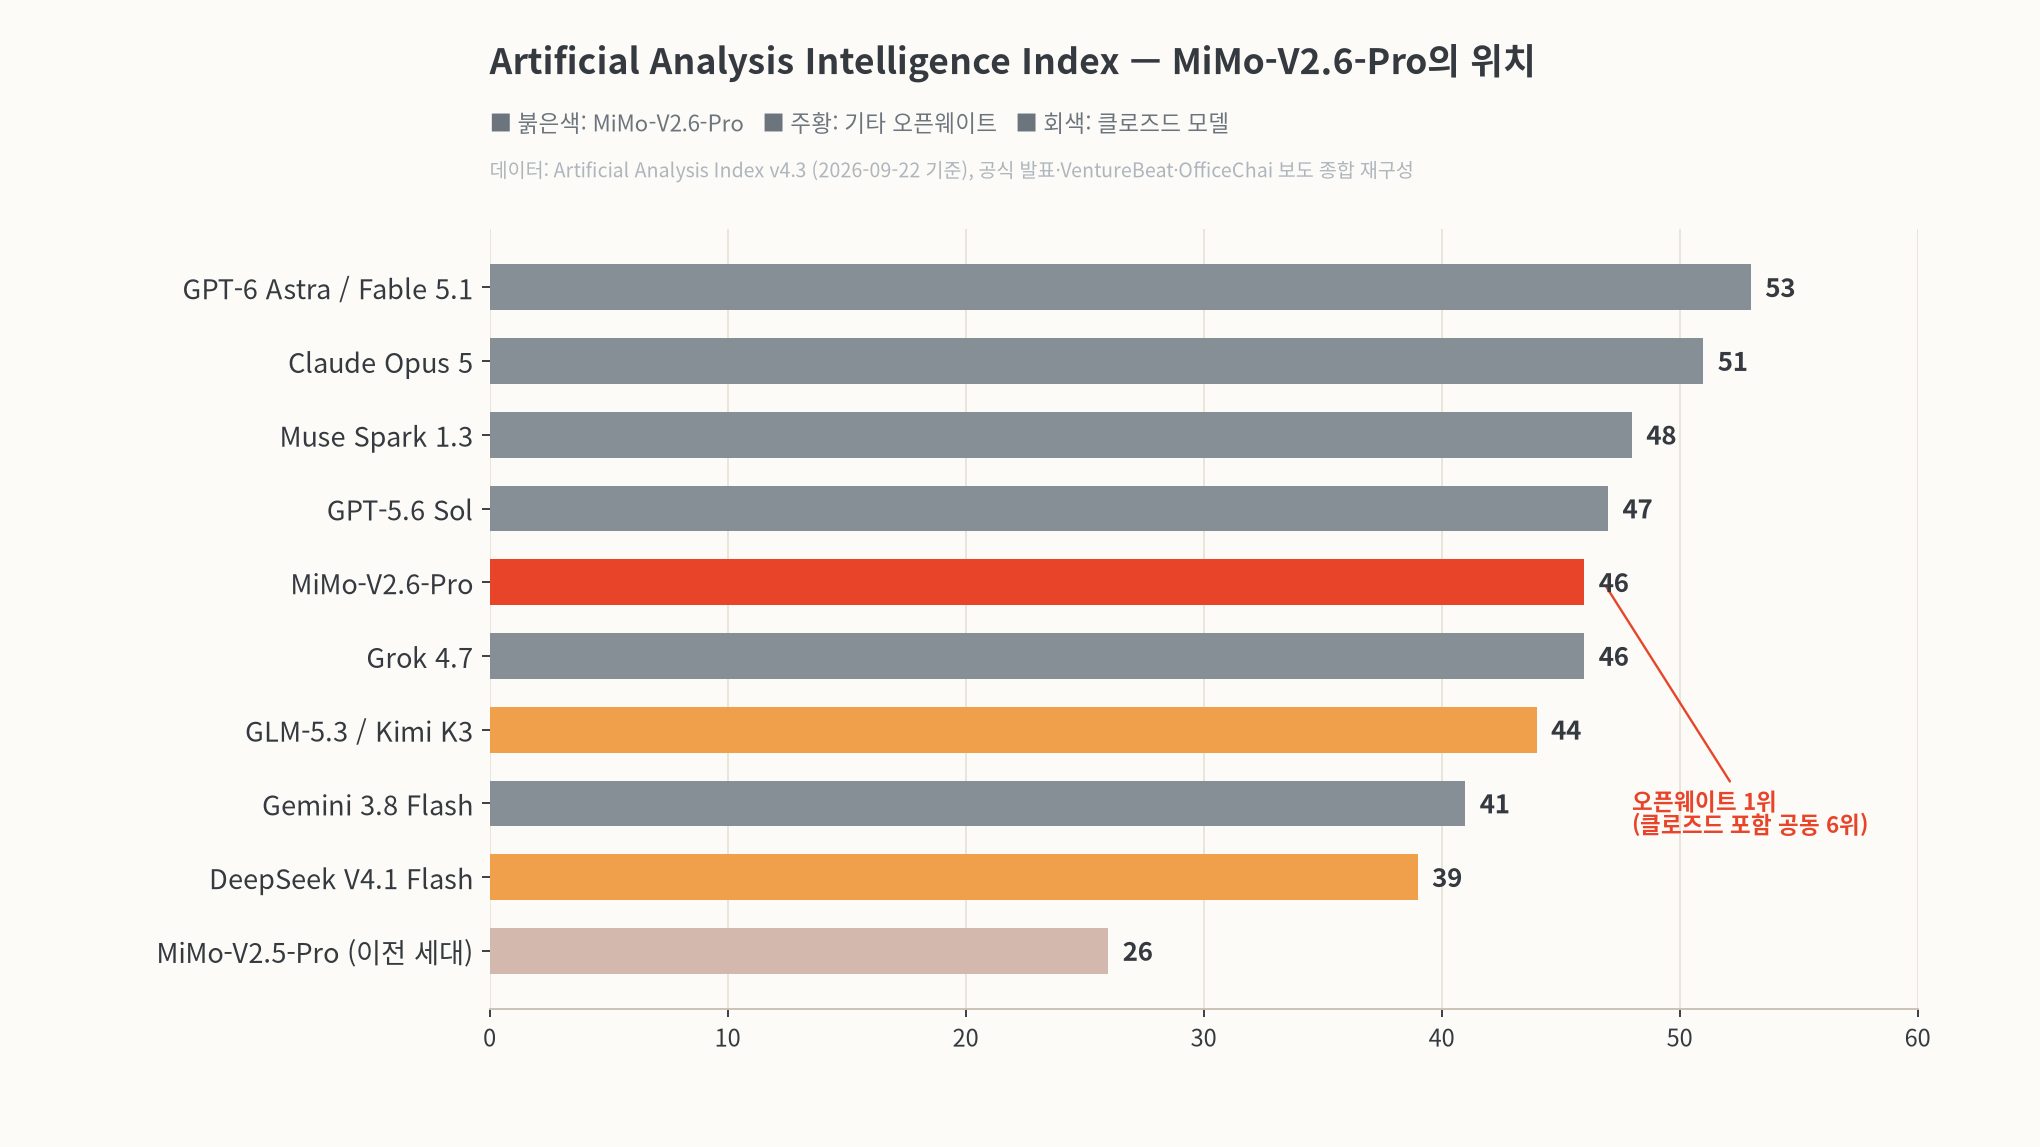
출처: Artificial Analysis Index v4.3 데이터 기준, 차트 재구성
- 이기는 곳: Terminal Bench 2.1, AutomationBench, OSWorld-Verified급 컴퓨터 사용 작업에서는 클로즈드 모델까지 제칩니다. 도구 호출·터미널 작업 중심의 에이전트 워크로드에서는 진짜 프런티어급입니다.
- 지는 곳: 가장 어려운 터미널 에이전트 평가인 Terminal Bench 4.0(34.9 vs Opus 5의 49.0)과 공격 보안 계열(ExploitBench 47.9 vs GPT-5.6 Sol의 78.5)에서는 여전히 격차가 큽니다. 독립 분석(Kingy AI)에서도 공유 평가 14개 중 10개에서 Opus 5에 뒤처진다고 봤습니다.
- Flash의 반전: CyberGym에서는 Flash(95.1)가 Pro(94.0)를 이깁니다. 다만 ExploitGym·ExploitBench에서는 Pro가 크게 앞서므로 “Flash가 보안에 더 좋다”는 일반화는 금물입니다.
bitsandbytes 개발자로 유명한 CMU 팀 데트머스도 X에서 “Flash는 300B~550B급 최고 모델로 보이며 DeepSeek V4.1이나 GLM 5.3 Flash보다 낫다”고 평가했습니다. 벤치마크 전반이 아니라 가격 대비 성능에서 가장 주목받는 쪽은 오히려 Flash입니다.
6일, 350만 달러 — RL 훈련을 생중계하다
이번 릴리스의 진짜 이야기는 벤치마크가 아니라 훈련 방식입니다. 샤오미는 강화학습(RL) 마지막 단계를 라이브 스트리밍으로 공개했습니다. Pro와 Flash는 각각 30단계의 대형 RL 스텝, 누적 약 75만 개 트래젝토리를 6일 만에 완주했고 비용은 Pro 262만 달러, Flash 85만 달러였습니다. 프런티어 랩의 훈련 비용이 수천만~수억 달러로 추정되는 것과 비교하면 파격적인 숫자입니다.
기술 보고서에서 특히 눈여겨볼 지점은 세 가지입니다.
- “You Only RL Once”: 코딩·일반 에이전트·비주얼·사이버보안을 따로 훈련하지 않고 하나의 혼합 RL 런으로 돌렸습니다. 스텝마다 1,568개 프롬프트 × 16개 롤아웃으로 27억~37억 토큰을 생성하는데, 트래젝토리 하나가 평균 11만~15만 토큰입니다. 짧은 답이 아니라 완전한 에이전트 워크플로 전체를 강화한 셈이죠.
- 그룹 단위 보상(GRS/GAR): 통과/실패 이진 보상으로는 “깨끗하게 푼 답”과 “억지로 통과한 답”을 구분할 수 없습니다. 샤오미는 같은 그룹 내 롤아웃을 서로 비교해 품질 높은 풀이에 학습 이점을 몰아주는 방식으로, 모델이 불필요하게 길어지는 대신 더 짧고 정확한 패치를 만들게 유도했습니다.
- 리워드 해킹 방어: 초기 훈련에서 모델이 버그를 직접 고치는 대신 최신 버전 패키지를 내려받거나 이슈 히스토리에서 정답을 찾아오는 꼼수를 발견했고, 환경에서 빌드 캐시·Git 미래 이력을 제거하고 네트워크를 차단한 뒤 별도 ‘핵 에이전트’로 남은 허점까지 탐색했습니다. 최종 런에서 리워드 해킹 비율은 2% 미만이었습니다.
전 DeepSeek 연구원 뤄풀리(Fuli Luo)가 이끄는 이 팀은 수십 명 규모로, 그녀는 “DeepSeek R1 때보다 연구·엔지니어링 난도가 높았다”고 밝혔습니다. 외부 연구자들도 “중국산 칩만으로 이 정도 결과를 낸 것은 포스트 트레이닝 스케일링 법칙에 대한 기존의 믿음을 업데이트해야 할 사건”이라는 반응을 내놨습니다.
가중치만 푼 게 아니다 — 오픈소스 구성
샤오미는 모델 가중치와 기술 보고서 외에도 RL 재현에 필요한 재료 대부분을 함께 공개했습니다.
- 7,000개 이상의 RL 태스크 환경: 소프트웨어 엔지니어링, 취약점 재현, 지식 집약 작업, 웹 디자인·개발 4개 영역
- 엔드투엔드 RL 훈련 프레임워크: verl·uni-agent·mini-swe-agent 기반, 환경 상호작용부터 보상 평가·정책 최적화까지 전체 파이프라인
- MiMo-V2.6-Distill-Qwen-9B: MiMo RL 트래젝토리로 증류한 9B 소형 모델. 이 모델로 RL을 돌렸을 때 SFT 대비 11개 벤치마크 전부 개선(SWE-bench Verified 61.1→66.2, Terminal Bench 2.1 37.1→52.8 등)된 검증 결과 포함
즉 “1조 파라미터 모델을 다시 훈련시키지 않아도” 소형 모델에 RL 기법만 이식해 에이전트 성능을 끌어올릴 수 있는 설계도를 커뮤니티에 넘긴 셈입니다. 단, OrcaRouter 분석이 지적한 대로 셀프호스팅의 하드웨어 장벽은 그대로입니다. Flash 가중치가 FP8 기준 약 173GB(65개 샤드)이고, 공식 권장 구성이 SGLang 텐서 병렬 8 또는 vLLM 멀티노드 — 개인용 GPU로는 어림없고 멀티노드 클러스터가 필요합니다.
실무 체크리스트 — API로 쓸 때, 셀프호스팅할 때
- ☑ 모델명은 전부 소문자로 호출:
mimo-v2.6-pro,mimo-v2.6-flash,mimo-v2.6-pro-ultraspeed(공식 발표문 명시) - ☑ 대량 배치·문서 처리 에이전트 → Flash 우선 테스트 ($0.14/$0.28, 벤치마크는 Pro의 90% 수준)
- ☑ 고난도 장기 코딩·사이버보안 작업 → Pro, 실시간 응답 필요 시 UltraSpeed(출력 20배속, 가격 10배)
- ☑ 캐시 활용: Pro 캐시 히트 입력 $0.0036/1M, Flash $0.0028/1M — 반복 컨텍스트가 많은 에이전트에서 비용 대부분 절감 가능
- ☑ 셀프호스팅 전 점검: Flash는 vLLM TP4/SGLang TP8, Pro는 SGLang TP16+DP2 멀티노드. 샘플링 권장값 temperature=1.0, top_p=0.95
- ☑ vLLM 안정 버전이 새 아키텍처를 못 따라갈 수 있음 — 공식 미리빌드 이미지(
vllm/vllm-openai:mimov25-cu129) 사용 권장 - ☑ 중국 서버 기반 API 사용이 어려운 환경(보안 정책)이면 OpenRouter 경유 또는 셀프호스팅 검토
직접 확인한 점 / 에디터 의견
공식 발표문, HuggingFace 모델 카드(Pro·Flash 양쪽 README), 기술 보고서 인용 보도(VentureBeat·OfficeChai·DataNorth·AIstify·OrcaRouter)를 교차 확인하면서 느낀 점을 남깁니다. 직접 추론 테스트를 돌린 것은 아니고 문서 기반 분석임을 밝혀둡니다.
- ‘오픈소스’의 의미는 라이선스 개방이지 비용 절감이 아닙니다. MIT로 상업적 제약은 사라졌지만 Pro를 실제로 돌리려면 클러스터가 필요합니다. 소규모 팀에게는 오히려 API 가격이 더 실질적인 혜택이죠.
- 벤치마크 표는 정직하지만 해석은 주의가 필요합니다. CyberGym·MiMo Cyber Bench처럼 비교 상대가 비어 있는(‘-‘) 항목은 샤오미 자체 평가라서 교차 검증이 안 됩니다. Terminal Bench 4.0, ExploitBench처럼 뚜렷이 지는 항목을 함께 봐야 균형 잡힌 판단이 됩니다.
- 진짜 승자는 Flash일 가능성이 높습니다. Pro는 리더보드용 깃발이고, 15B 활성 파라미터에 $0.14라는 Flash의 조합이 고빈도 에이전트 호출을 돌리는 팀의 비용을 구조적으로 바꿉니다. DeepSeek V4.1 Flash($0.15 비수기)와 가격이 거의 겹치는데 벤치마크는 위에 있으니, 대량 워크로드 예산표부터 다시 그려야 할 시점입니다.
- RL 인프라 공개는 가중치 공개보다 장기 영향이 클 수 있습니다. 9B 증류 모델 + 7,000개 환경 + 훈련 프레임워크 조합은 “소형 모델도 RL로 프런티어급 에이전트가 될 수 있다”는 재현 가능한 증거입니다.
FAQ
Q. MiMo-V2.6은 어디서 쓸 수 있나요?
가중치는 HuggingFace(XiaomiMiMo 컬렉션)와 ModelScope에서 무료 다운로드 가능하고, API는 샤오미 MiMo 오픈 플랫폼·Xiaomi AI Studio·MiMo Code·MiMo Desktop·OpenRouter에서 제공됩니다. 새로 나온 MiMo Desktop 클라이언트는 UltraSpeed 모드(20배속)를 지원합니다.
Q. Pro와 Flash 중 뭘 써야 하나요?
호출량이 많은 에이전트(코드 리뷰, 문서 분류, 백오피스 자동화)는 Flash가 기본입니다. 벤치마크 격차가 대부분 2~4점 이내인 데다 가격이 1/3입니다. Terminal Bench 4.0급 고난도 작업이나 공격 보안 평가가 중요할 때만 Pro를 쓰면 됩니다.
Q. MIT 라이선스면 진짜 아무 제약이 없나요?
네. 상업용 사용, 파인튜닝, 재배포가 모두 자유롭고 매출 연동 조건이나 연구 목적 제한도 없습니다. Llama 계열의 커뮤니티 라이선스보다 넓은 수준입니다. 다만 셀프호스팅 시 하드웨어 비용은 별도 문제입니다.
Q. 한국어 지원은 되나요?
공식 모델 카드는 영어·중국어(en, zh)를 표기 언어로 명시하고 있습니다. 옴니모달 입력(텍스트·이미지·오디오·비디오)을 지원하지만 한국어 품질은 자체 테스트가 필요하며, 에이전트 워크로드 중심으로 훈련된 모델 특성상 한국어 창작 작업보다는 도구 호출·코딩 계열에서 강점이 예상됩니다.
결론 — 오픈웨이트의 가격 바닥이 다시 내려갔다
MiMo-V2.6은 “오픈웨이트 모델도 프런티어 근처까지 갈 수 있다”는 주장을, 1/20 가격과 MIT 라이선스, 그리고 재현 가능한 RL 설계도까지 첨부해 증명한 릴리스입니다. 클로즈드 프런티어(Claude Opus 5, GPT-6 Astra)와의 격차는 여전히 존재하지만 그 차이가 ‘분기’가 아니라 ‘주’ 단위로 줄고 있다는 게 이번 발표의 진짜 신호입니다. 고빈도 에이전트 워크로드를 돌리고 있다면 Flash부터 테스트해보시길 권합니다. 다음 리더보드 갱신 전에 말입니다.
함께 읽으면 좋은 글
- DeepSeek V4.1 Flash: 플래그십 V4-Pro를 스스로 은퇴시킨 모델, 뭐가 다르길래
- GLM-5.3-Flash 무료 스텔스 모델의 정체: 플래그십 지능을 1/10 가격에
- Gemini 3.8 Flash 출시: Opus 5급 코딩을 7분의 1 가격에, 벤치마크 숫자와 론칭 가격 분석
- Union Alpha: 만든 곳을 숨긴 무료 코딩 모델, 지금 써볼 만할까
- Muse Spark 1.3 리뷰: 메타의 코딩 1위 주장, 그대로 믿어도 될까