작성자: 서상덕(Apptics 에디터) — AI 모델·개발 도구 실무 적용 관점에서 공식 발표문, Artificial Analysis 벤치마크, 시스템 카드, 개발자 커뮤니티 반응을 교차 확인해 정리한 리뷰입니다.
출시 일주일 만에 자기 모델을 갈아치운 OpenAI
9월 22일 GPT-6 Sol이 나왔습니다. 그리고 정확히 7일 뒤인 9월 29일, OpenAI는 GPT-6.1 Sol을 발표하며 6 Sol을 사실상 즉시 교체했습니다. 모델 수명 일주일. 프런티어 랩 역사에서도 찾기 어려운 속도입니다.
공식 발표문의 부제는 “Near-Astra intelligence for a fifth of the price” — 플래그십 GPT-6 Astra에 근접한 지능을 5분의 1 가격에 제공한다는 선언입니다. 숫자만 보면 매력적이지만, 개발자 커뮤니티의 반응은 결이 조금 다릅니다. “지난주 6 Sol이 별로였으니 급히 수습한 것 아니냐”는 시선이 상당하거든요.
이 글에서는 발표문·벤치마크·시스템 카드에 나온 사실과, Hacker News(741포인트, 댓글 102개)에서 개발자들이 직접 전한 사용 반응을 나눠서 정리합니다. 마케팅 수치와 현장 체감 사이의 간극을 확인하는 것만으로도 전환 판단에 도움이 될 겁니다.
30초 요약
- GPT-6.1 Sol: 9월 29일 출시, API ID
gpt-6.1-sol, 입력 $2 / 출력 $10 / 캐시 입력 $0.10 (백만 토큰당) - AA Intelligence Index 52점(max) — Astra(53점)와 1점 차이, 태스크당 비용은 $0.72 vs $3.26으로 4분의 1 이하
- 코딩 에이전트 지표에서는 xhigh 설정이 Astra(max)를 1점 앞섬, 비용은 15% 미만
- 단, 커뮤니티에는 “6 Sol 품질 저하를 급히 땜질한 것”이라는 회의론 — 전환 전 자체 검증 권장
- ChatGPT 일반 Chat에서는 아직 사용 불가. Work·Codex·API에서 먼저 제공
스펙 한눈에 보기 — 가격이 진짜 무기다
먼저 하드 스펙부터 확인하죠. OpenAI 공식 모델 문서 기준입니다.
| 항목 | GPT-6.1 Sol | GPT-6 Astra(플래그십) | GPT-6 Luna(경량) |
|---|---|---|---|
| API 모델 ID | gpt-6.1-sol | gpt-6-astra | gpt-6-luna |
| 입력 가격(MTok) | $2 | $10 | $0.1 |
| 출력 가격(MTok) | $10 | $50 | $0.5 |
| 캐시 입력(MTok) | $0.10 (95% 할인) | — | — |
| 컨텍스트 윈도우 | 1.05M | 1.05M | 1M |
| 최대 출력 | 128K | 128K | — |
| 추론 강도 | low~max 5단계 | low~max 5단계 | low~max |
| 지식 마감 | 2026-04-30 | 2026-04-30 | — |
| 도구 | Functions·웹검색·파일검색·컴퓨터 사용 | 동일 | 동일 |
표에서 가장 눈여겨볼 숫자는 캐시 입력 $0.10입니다. 기존 6 Sol 대비 캐시 할인이 90%에서 95%로 강화됐는데, Hacker News에서는 “사실상의 진짜 발표는 이 캐시 가격”이라는 반응이 최상위권이었습니다. Codex처럼 같은 컨텍스트를 반복해서 쓰는 에이전트 워크로드에서는 체감 비용이 크게 내려갑니다.
벤치마크: Astra와 1점 차이, 비용은 4분의 1
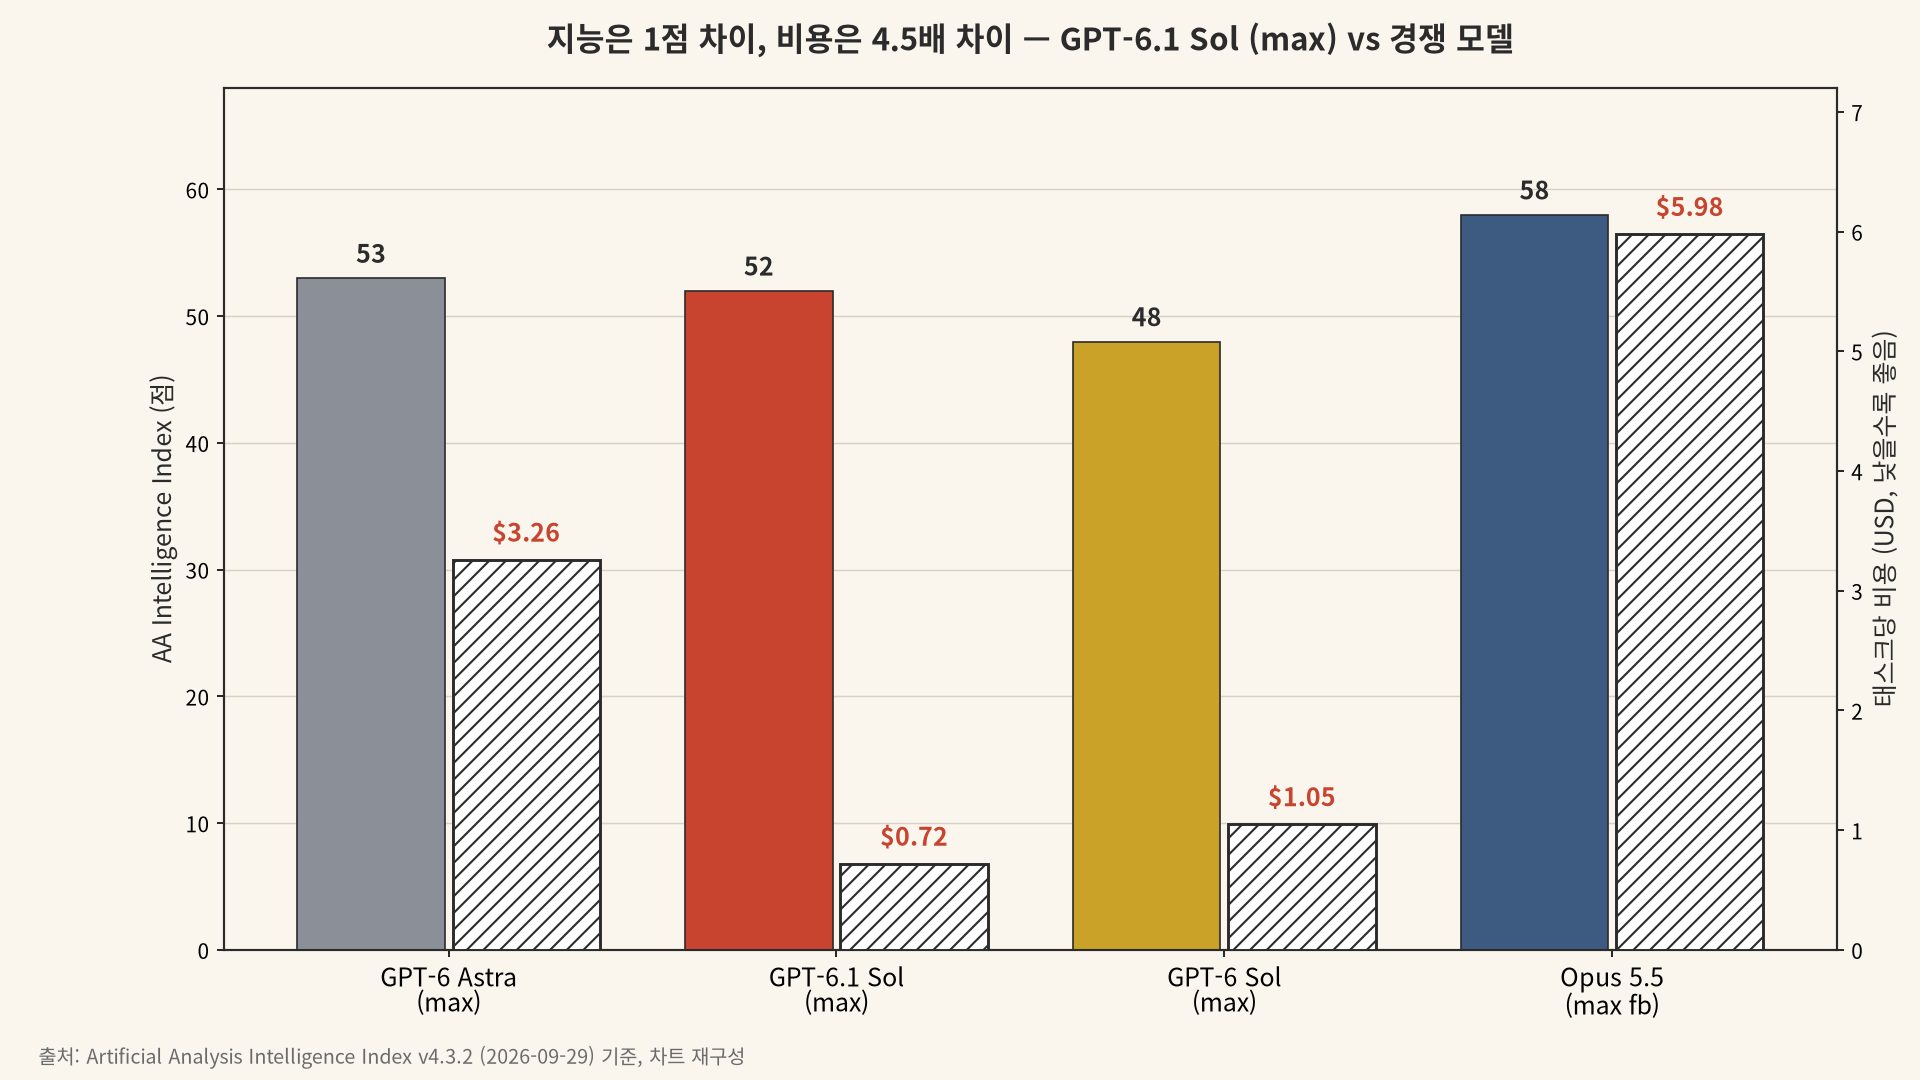
출처: Artificial Analysis Intelligence Index v4.3.2 (2026-09-29) 데이터 기준, 차트 재구성
Artificial Analysis가 9월 29일 발표한 독립 벤치마크 결과가 이 출시의 핵심 근거입니다.
- AA Intelligence Index: GPT-6.1 Sol(max) 52점 — 6 Sol에서 4점, GPT-5.6 Sol에서 5점 상승. Astra(53점)와는 단 1점 차이인데 태스크당 비용은 $0.72 vs $3.26으로 4분의 1 이하입니다.
- 코딩 에이전트 지표: xhigh 설정에서 Astra(max)를 1점 앞섰습니다(비용은 15% 미만). 흥미로운 점은 max보다 xhigh가 3점 더 높았다는 것 — “무조건 최대 추론”이 정답이 아닙니다.
- DeepSWE v1.1(실제 코드베이스 소프트웨어 공학): 71.9% — 6 Sol 최고점보다 6.4%p 높고 Astra와 동급을 5분의 1 비용에 달성.
- Terminal-Bench 4.0: +12점, Humanity’s Last Exam: +5점, GDP.pdf(전문 문서 이해): +6점.
- 환각률: AA-Omniscience 기준 60% → 54%로 하락. low 추론 강도에서 사실 오류 응답 비율은 11.4% → 7.7%로 약 32% 감소.
- 과학 워크플로 비용(Terminal-Bench Science, max): 태스크당 평균 $5.47 — Opus 5.5($23.21), Astra($23.80)의 4분의 1 수준. 단 절대 점수는 Astra(68.1%)가 여전히 1위입니다.
한 가지 짚고 넘어갈 점: 전체 1위는 여전히 Claude Opus 5.5(Index 58점)입니다. 다만 태스크당 $5.98로 비용이 8배라, “절대 성능이냐 비용 효율이냐”의 선택지가 명확해졌다고 보면 됩니다.
커뮤니티 체감: 숫자와 분위기는 왜 다른가
여기서부터가 “실사용기”의 핵심입니다. 저는 이번 주 안에 6.1 Sol을 장기간 운영해본 것은 아니지만, Hacker News 스레드(741포인트)에 올라온 실제 사용자들의 1차 반응은 꽤 선명한 그림을 보여줍니다.
부정적 신호 — 6 Sol의 평판 문제
- “6 Sol은 단순 리팩터링에서도 5.6 Sol 대비 품질 저하가 뚜렷했다. Opus 5.5로 갈아탔다” — 반년 넘게 Codex를 밀던 개발자의 이탈 증언
- “6 Sol 출시 직후 품질이 몇 주간 너무 나빴다. 이 벤치마크 점수들을 어떻게 믿나”
- “사실 GPT-6 Terra로 내놨어야 할 모델을 Sol이라는 이름으로 잘못 출시한 것의 수습”이라는 이름 관련 음모론성 해석도 다수
- Codex 팝업에서 6.1 Sol을 고르니 셀렉터에 “GPT-6 Astra Light”가 표시됐다는 목격담 — 6.1 Sol이 Astra의 경량/증류 버전일 수 있다는 추측
- ChatGPT 구독(Pro 500)의 사용량 허용치가 줄었다는 불만도 같은 날 나옴 — “API 가격은 내리고 구독은 조이는” 이중 전략 지적
긍정적 신호
- “캐시 $0.10이 진짜 발표다. Codex에서 뽑아 쓸 수 있는 양이 훨씬 늘 것”
- “Ultrafast 모드(최대 8배 빠른 토큰 생성)가 진짜 게임 체인저”
- “프런티어 모델이 $2/$10이라니 저렴하다” — 절대 가격에 대한 놀라움
- 3D 그래픽(Blender) 작업자들은 “Astra의 절반만 해도 게임 체인저”라며 기대
직접 확인한 점 / 에디터 의견
발표문·시스템 카드·AA 리포트를 교차 검증하며 확인한 사실 3가지입니다.
- 사이버 등급이 Critical입니다. 시스템 카드 부록상 GPT-6.1 Sol은 Preparedness Framework 기준 사이버보안 ‘Critical’, 생화학 ‘High’ 등급으로 Astra와 동일한 안전장치 스택을 씁니다. “중간급 모델이라 안전 장치가 느슨하다”는 오해는 금물입니다. 자동 안전 리뷰어 우회 시도 0건은 Astra와 동일.
- xhigh > max 역전 현상은 실제 데이터입니다. AA 측정에서 코딩 지표가 max(50점대)보다 xhigh에서 더 높게 나왔습니다. 에이전트 코딩 워크로드라면 기본값을 max로 두지 말고 xhigh를 직접 비교 테스트할 가치가 있습니다.
- 출력 토큰이 6 Sol보다 10~30% 많습니다. 지능이 올라간 대가로 더 길게 씁니다. 토큰 단위 가격이 아니라 태스크당 총비용으로 비교해야 정확한 판단이 됩니다.
종합하면, 벤치마크상 가성비 주장은 독립 기관 데이터로 뒷받침되는 반면, 6 Sol에서 실망한 사용자의 신뢰를 되찾을지는 실제 배포 후 1~2주가 판가름할 것으로 봅니다. 프로덕션 전환은 대규모 마이그레이션 전에 자체 워크로드 스모크 테스트를 거치는 것을 권합니다.
Artificial Analysis 벤치마크 분석 원문
지금 어디에서 쓸 수 있나
- ChatGPT Work + Codex: Plus·Pro·Business·Enterprise·Edu 사용자 대상 즉시 제공
- 일반 ChatGPT Chat: 아직 미제공 (공식 발표문 명시)
- OpenAI API: 모델 ID
gpt-6.1-sol, Responses API·SDK에서 사용 가능 - Ultrafast(Codex 기준 최대 8배 빠른 생성): “수일 내” 제공 예고
전환 판단 체크리스트
- ☐ 현재 6 Sol 또는 5.6 Sol을 API로 쓰는가? → 가격 동일·성능 상승이라 전환 리스크 낮음. 모델 ID만 교체 후 회귀 테스트
- ☐ 반복 컨텍스트가 많은 에이전트(RAG·Codex)인가? → 캐시 95% 할인 효과 극대화. 프롬프트 캐싱 활성화 확인
- ☐ Astra급 품질이 필수인 워크로드(최난도 과학·연구)인가? → 여전히 Astra 유지, 나머지만 6.1 Sol로 라우팅
- ☐ Anthropic 계열(Opus 5.5)을 쓰는가? → 절대 성능은 Opus 우위, 비용 8배 차이. 태스크 단위 A/B 비교 권장
- ☐ 추론 강도 설정을 검토했는가? → 코딩 에이전트는 xhigh, 단순 작업은 low~medium으로 비용 최적화
- ☐ ChatGPT 웹 Chat만 쓰는 개인 사용자인가? → 아직 미제공. Codex/Work 가입 여부 확인
FAQ
Q1. GPT-6.1 Sol이 GPT-6 Astra의 경량 버전인가요?
OpenAI는 아키텍처를 공식 공개하지 않았습니다. 다만 시스템 카드가 “GPT-6 Astra 시스템 카드의 부록(Addendum)” 형태이고, 커뮤니티에서는 Astra 증류/경량 버전설과 Codex 셀렉터에 “Astra Light”가 찍혔다는 목격담이 돕니다. 공식적으로는 “Astra에 근접한 지능의 독립 모델”이라는 표현만 확인됩니다.
Q2. GPT-6 Sol은 이제 못 쓰나요?
AA 리더보드에는 아직 남아 있지만, 출시 7일 만에 후속 모델에 자리를 내준 만큼 신규 프로젝트에 채택할 이유는 없습니다. 기존 통합은 gpt-6.1-sol로 마이그레이션을 권장합니다(가격 동일).
Q3. 무료 사용자는 어디서 써볼 수 있나요?
현재 ChatGPT 일반 Chat에는 제공되지 않습니다. Plus 이상 구독자는 ChatGPT Work와 Codex에서, 개발자는 OpenAI API(종량제)에서 쓸 수 있습니다.
Q4. 추론 강도는 뭐가 기본인가요? 어떤 걸 써야 하나요?
low·medium·high·xhigh·max 5단계를 지원합니다. AA 데이터상 코딩 에이전트에서는 xhigh가 max보다 3점 높았으니, 코딩 용도라면 xhigh부터 테스트하세요. 단순 문서 작업은 medium으로도 Index 48점을 냅니다(태스크당 $0.21).
Q5. 안전성 등급이 Astra와 같은 ‘Critical’이라던데, 사용이 제한되나요?
등급은 Preparedness Framework상 내부 평가 등급으로, Astra와 동일한 안전장치 스택이 적용된다는 뜻입니다. 일반 개발 사용이 추가로 제한되지는 않으며, 자동 안전 리뷰어 우회 시도 0건 등 정렬 평가는 6 Sol 대비 개선됐습니다.
결론: 가성비 1순위 후보, 단 신뢰는 직접 검증
GPT-6.1 Sol은 벤치마크상으로는 의심할 여지 없는 비용 효율 프런티어의 새 기준점입니다. Astra와 1점 차이의 지능을 4분의 1 비용에, 캐시 토큰은 95% 할인. 특히 반복 컨텍스트를 쓰는 에이전트 워크로드라면 체감 절감폭은 더 커집니다.
다만 “7일 만의 교체”라는 이례적인 타임라인과 6 Sol의 나빴던 초기 평판은, 숫자보다 배포 후 체감이 중요하다는 교훈을 남깁니다. 프로덕션 전환 전에 대표 워크로드 3~5개로 스모크 테스트를 돌리고, 추론 강도(xhigh vs max)를 직접 비교한 뒤 결정하세요.
다음 단계로는 Codex에서 6.1 Sol을 기본 모델로 지정하고 이번 주 작업 한 건을 xhigh와 max로 각각 돌려보는 것을 추천합니다. 비용 차이는 캐시 히트율과 함께 API 사용량 대시보드에서 바로 확인할 수 있습니다.
함께 읽으면 좋은 글
- GPT-6 Astra 공개: 벤치마크·가격·사이버 등급 완전 정리 — 상위 플래그십의 전체 스펙
- Claude Opus 5.5 출시: 개발자가 오늘 고쳐야 할 파괴적 변경 4가지 — 절대 성능 1위 모델과의 비교
- Gemini 3.8 Flash 출시: Opus 5급 코딩을 7분의 1 가격에 — 가성비 경쟁 구도 정리
- DeepSeek V4.1 Flash: 플래그십을 스스로 은퇴시킨 모델 — 가격 파괴의 또 다른 축
- MiMo-V2.6 오픈웨이트 공개: 1/20 가격으로 오픈소스 1위를 바꾸다 — 저가 모델 시장 전체 흐름