작성자: Apptics 에디터 — AI 모델·개발 도구 출시 소식을 공식 문서와 독립 벤치마크 기준으로 교차 확인해 정리합니다. 이 글은 2026년 10월 13일 Gemini 4 Argon 일반 공개(GA) 이후의 공식 개발자 문서, Artificial Analysis·Vals AI 독립 평가, 실무자 반응을 근거로 작성했습니다.
9월 30일, 구글이 벤치마크 1위 모델을 내놓고 정작 아무도 못 쓰게 막았습니다. 사이버 보안 파트너 전용이었죠. 그로부터 딱 2주 뒤인 10월 13일, Gemini 4 Argon이 드디어 일반 개발자에게 열렸습니다. 문제는 지금입니다. 11월 30일까지만 도입 프로모션 가격($2/$10)이 적용되고, 12월 1일부터는 가격이 2배로 뛴다는 점. 지금 내 워크로드에 맞는 모델인지 테스트할 수 있는 창이 한 달 반밖에 남지 않았습니다.
게다가 API 호출 방식도 기존 Gemini와 꽤 달라졌습니다. temperature는 무시되고, thinking_budget은 폐기됐고, 출력 한도를 제대로 설정하지 않으면 빈 응답만 받고도 과금됩니다. “그냥 모델명만 바꾸면 되겠지” 하고 넘어가면 사고가 납니다.
30초 요약
- 출시 일정: 9월 30일 Fairwind 보안 파트너 전용 공개 → 10월 13일 개발자·기업 대상 일반 공개(GA)
- 가격: 11월 30일까지 100만 토큰당 입력 $2·출력 $10, 12월 1일부터 $4·$20. 캐시 입력은 95% 할인($0.10)
- 핵심 스펙: 입력·추론·출력이 공유하는 1M 토큰 통합 윈도우, 출력 기본 한도 64K → long decode로 최대 1M
- 강점: 장문 지식 업무(법률·금융), 초대형 코드 마이그레이션, 긴 영상 이해, 최저 환각률(15%)
- 약점: 터미널 코딩·컴퓨터 조작은 Claude Opus 5.5, GPT-6 Astra에 뒤처짐
지금 어디서 쓸 수 있나
Argon은 모델 ID gemini-4-argon으로 다음 채널에서 호출할 수 있습니다. 무료 티어에는 없습니다.
- Gemini API 유료 티어 —
google-genaiSDK 첫날 지원, AI Studio Playground에서 바로 테스트 가능 - Google Antigravity — 구글의 에이전트 코딩 환경. 개인은 AI Ultra 구독 필요. Alphabet 내부에서는 이미 월 10만 명 이상이 사용 중이며, 4주간 에이전트 작성 코드 35% 증가·배포 후 롤백 30% 감소가 보고됐습니다
- Gemini 앱·검색 AI 모드 — AI Pro/Ultra 구독자 대상 순차 적용
- Android Studio, Firebase AI Logic, Vertex AI, Gemini Enterprise
- 서드파티: Vercel AI SDK, LiteLLM, OpenRouter 등 주요 하네스도 출시 당일 지원
재미있는 점은 Pro/Flash 같은 등급 라벨이 사라졌다는 것입니다. 세대 번호+코드명(Argon)만 남았고, 라인업 최상단에서 Gemini 3.1 Pro Preview를 대체합니다.
가격: 12월 1일이 데드라인
도입 가격은 11월 30일까지이고 이후 정가의 2배가 적용됩니다. 100만 토큰당 기준입니다.
| 티어 | 현재 (~11/30) | 12/1 이후 |
|---|---|---|
| Standard 입력/출력 | $2 / $10 | $4 / $20 |
| Batch·Flex 입력/출력 | $1 / $5 | $2 / $10 |
| Priority 입력/출력 | $3.60 / $18 | $7.20 / $36 |
| 캐시 입력 | $0.10 | $0.20 |
비교 대상인 Gemini 3.8 Flash가 $0.75/$3.75이니 “Flash보다 비싸다”는 인상만으로는 판단하면 안 됩니다. 실제 관건은 출력량입니다. Artificial Analysis 측정 기준 Argon은 작업당 평균 6만 2천 토큰을 출력합니다(GPT-6 Astra는 약 2만 7천). 같은 지능 지수 53점 기준 작업당 비용은 프로모션가에서 $1.99로 Astra($3.26)의 60%지만, 정가에서는 $3.98로 역전 직전까지 갑니다. 대량 호출이라면 Batch 티어(정가의 절반)를 기본값으로 검토하세요.
API에서 바뀐 것 — 마이그레이션 필수 체크
기존 Gemini 코드에서 모델명만 바꾸면 경고가 쏟아집니다. 공식 마이그레이션 체크리스트의 핵심은 이렇습니다.
thinking_budget폐기 →thinking_level사용: low/medium/high 3단. 기본값은 medium이고, 추론을 완전히 끄는 옵션은 없습니다temperature,top_p,top_k무시: 샘플링 커스터마이징에 의존하던 코드는 다른 접근이 필요합니다- 명시적 캐싱 제거:
cached_content호출을 빼면 암묵적 캐싱이 자동으로 동작하고, 4,096토큰 이상 반복 프롬프트에 95% 할인이 붙습니다 - 타임아웃 확대: 고난도 추론은 수 분이 걸릴 수 있습니다. HTTP 타임아웃을 최소 15~20분으로
- 1M 통합 윈도우: 입력+추론+출력이 하나의 1,048,576토큰을 공유합니다. 90만 토큰 프롬프트를 넣으면 답에는 15만 토큰만 남습니다
- long decode: 기본 출력 한도는 여전히 65,536토큰. 그 이상은
background=True와max_output_tokens상향으로 백그라운드 생성(최대 24시간, 폴링 방식)을 써야 합니다. 호프마다 과금되지만 재입력분은 캐시 할인이 적용됩니다
벤치마크: 어디서 이기고 어디서 지나
구글 발표와 독립 평가를 교차하면 그림이 명확합니다. “전능한 1위”가 아니라 지식 업무 특화 1위에 가깝습니다.
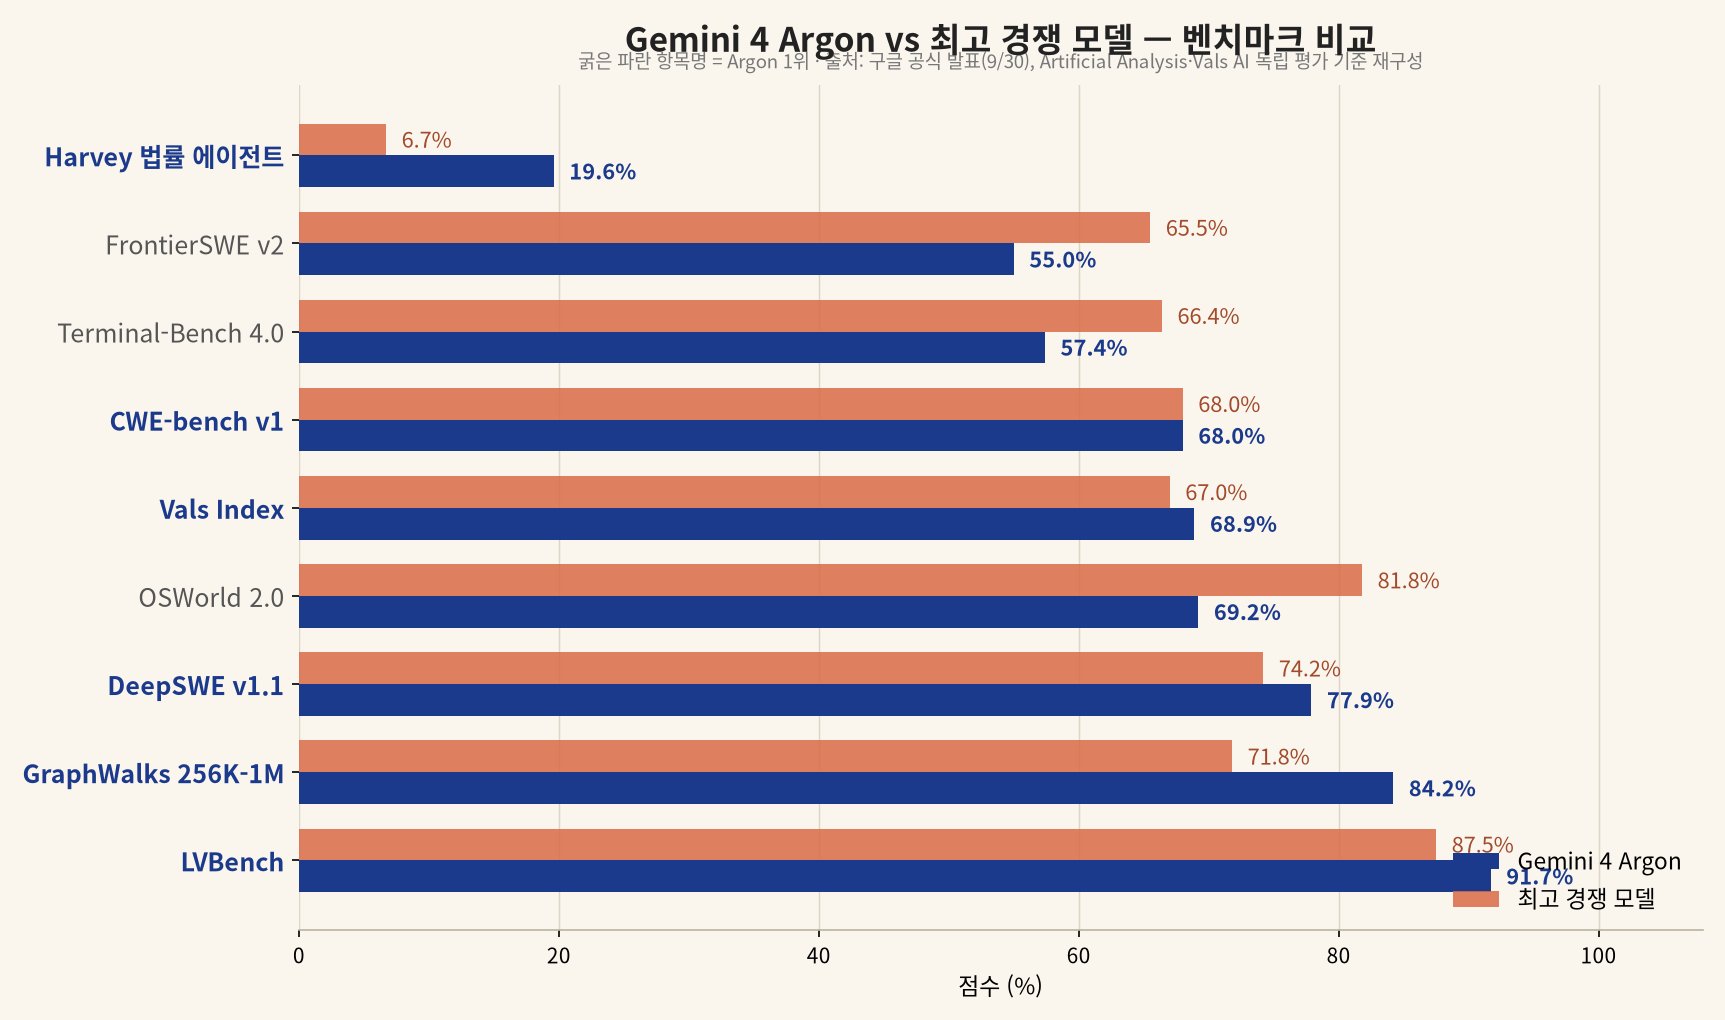
| 벤치마크 | Argon | 최고 경쟁 모델 |
|---|---|---|
| DeepSWE v1.1 (장기 코딩) | 77.9% | Opus 5.5, 74.2% |
| Vals Index (금융·법률·세무) | 68.9% | Opus 5.5, 67.0% |
| Harvey 법률 에이전트 | 19.6% | Fable 5.1, 6.7% |
| GraphWalks 256K–1M (초장문) | 84.2% | Astra, 71.8% |
| LVBench (긴 영상 이해) | 91.7% | Astra, 87.5% |
| CWE-bench v1 (취약점 패치) | 68.0% | Astra, 68.0% (공동 1위) |
| Terminal-Bench 4.0 | 57.4% | Opus 5.5, 66.4% |
| FrontierSWE v2 (초장기 코딩) | 55.0% | Astra, 65.5% |
| AA 지능 지수 | 53 | Opus 5.5, 58 (Astra와 동점) |
한 가지 눈에 띄는 특성: Argon의 환각률은 15%로 상위 모델 중 최저지만, 같은 시험의 정답률은 50%로 Astra(63%)보다 낮습니다. 모르는 문제를 찍지 않고 거부하기 때문입니다. 법률·금융 문서 검토에서는 이 특성이 장점입니다 — 틀린 숫자가 슬며시 넘어가는 것보다 “모르겠다”가 눈에 띄니까요. 반면 매 요청에 반드시 답이 필요한 파이프라인에는 맞지 않습니다.
에디터가 짚은 실전 포인트
공식 문서와 독립 벤치마크를 교차 확인하면서 정리한, 문서에 흩어져 있어 놓치기 쉬운 점들입니다(직접 유료 호출 테스트는 진행 전이라 근거는 공식 문서·독립 측정 수치입니다).
- 벤치마크의 thinking_level 함정: 공개된 모든 점수는 high 설정에서 측정됐습니다. API 기본값은 medium이라, 그대로 호출하면 벤치마크와 다른 결과가 나옵니다. 레벨을 코드에 명시적으로 고정하세요
- 빈 응답 과금:
max_output_tokens를 8,192 같은 낮은 값으로 두면 추론이 예산을 다 쓰고 답을 시작도 못 합니다. 32,768 이상 권장 - 첫 토큰 지연: high 설정 기준 첫 토큰까지 약 45초. 지연 민감 경로에는 Argon을 두지 마세요
- 프런트엔드는 유보: Bloomberg 보도에 따르면 내부 접근 권한이 있는 구글 엔지니어들도 실제 코딩, 특히 프런트엔드 디자인에서 답답함을 언급했습니다. 프런트엔드 위주라면 자체 평가부터
전환 판단 체크리스트
- ☐ 내 워크로드가 계약서·법률 문서·긴 로그 분석 같은 장문 지식 업무인가 → Argon 우위 구간, 즉시 테스트
- ☐ 대규모 코드 마이그레이션(C++→Rust 등)이 있는가 → long decode로 수동 청크 분해 없이 처리 가능
- ☐ 터미널·데스크톱 조작 에이전트인가 → 당분간 Opus 5.5·Astra 유지가 합리적
- ☐ 11월 30일 전에 벤치마크를 돌려보고, 예산은 12월 정가($4/$20) 기준으로 책정했는가
- ☐
temperature·thinking_budget의존 코드를 정리하고 타임아웃을 15분+로 올렸는가 - ☐ “모르겠다” 응답을 감지해 사람이나 다른 모델로 라우팅하는 처리를 넣었는가
FAQ
무료로 쓸 수 있나요?
Gemini API 무료 티어에는 없습니다. 유료 티어 결제 계정이 필요하고, Gemini 앱에서는 AI Pro/Ultra 구독자부터 순차 적용됩니다. AI Studio Playground에서 유료 티어로 테스트하는 것이 가장 빠른 입문 경로입니다.
Opus 5.5, GPT-6 Astra 중 뭘 써야 하나요?
작업 유형으로 나누는 게 답입니다. 터미널 코딩·컴퓨터 조작은 Opus 5.5/Astra, 문서 중심 지식 업무·초장문 컨텍스트·법률 금융 에이전트는 Argon이 현재 우위입니다. 단일 벤치마크 1위가 아니라 워크로드 적합성으로 선택하세요.
출력 100만 토큰을 실제로 다 쓰나요?
아니요. 구글에 따르면 채팅·Q&A·추출 작업은 대부분 32K 토큰 미만에서 끝납니다. 1M 출력은 대규모 마이그레이션, 긴 증명, 다중 파일 diff 같은 소수 케이스용이고, 모든 호프가 과금 대상이라 비용 계산이 필수입니다.
프로모션 가격은 언제 끝나나요?
공식 문서 기준 11월 30일까지이고 12월 1일부터 정가($4/$20)가 적용됩니다. 대량 도입을 검토 중이라면 가격 확정 전에 파일럿 평가를 끝내는 편이 안전합니다.
결론
Gemini 4 Argon은 “구글의 귀환”이라는 헤드라인과 달리, 실제로는 선택적 1위입니다. 지식 업무와 장문 처리에서는 대체하기 어려운 숫자를 냈지만, 터미널 에이전트에서는 아직 Claude와 OpenAI가 위입니다. 다만 프로모션 기간의 작업당 비용($1.99)과 1M 통합 윈도우는, 문서·코드 대용량을 다루는 팀이라면 한 번쯤 파일럿을 돌릴 충분한 이유가 됩니다. 데드라인은 11월 30일, 테스트는 지금이 가장 쌉니다.
함께 읽으면 좋은 글
- Gemini 4 Argon 공개: 1위 모델을 왜 아무도 못 쓰게 했나
- Claude Opus 5.5 출시: 개발자가 오늘 고쳐야 할 것들
- GPT-6.1 Sol 일주일 만의 교체: Astra급 지능을 1/5 가격에
- Gemini 3.8 Flash 출시: Opus 5급 코딩을 7분의 1 가격에