작성자: Apptics 에디터 — 개발 도구·AI 에이전트 생태계를 공식 문서와 커뮤니티 실측 후기 기준으로 교차 확인해 정리합니다. 이 글은 REA 공식 README, 개발자 가이드, 실제 비용 측정 후기(YouTube·dev.to), Reddit 사용자 경험을 근거로 작성했습니다(직접 실행 테스트는 하지 않았으므로 그 부분은 근거를 명시합니다).
다른 앱에서 “이 기능 진짜 잘 만들었다” 싶은 걸 본 적 있으신가요? 오프라인 즉시 검색, 절묘한 동기화 동작, 매끄러운 업데이트 플로우. 내 제품에도 넣고 싶은데 소스 코드는커녕 문서도 없습니다.
예전 답은 “역공학을 배우세요”였습니다. 디스어셈블러를 고르고, API를 익히고, 심볼과 문자열을 뒤지고, 콜 그래프를 손으로 따라가는 깊은 전문 영역이었죠. 그런데 최근 GitHub에서 이 장벽을 통째로 허문 저장소가 나왔습니다. REA(Reverse Engineer Anything) — 출시 며칠 만에 스타 6만 개, 하루 만에 10만 개 돌파 소식이 돌더니 현재 22만 개를 넘겼습니다.
무엇보다 섬뜩한 쪽은 “내가 만드는 앱도 이렇게 분해될 수 있다”는 점입니다. 그래서 오늘은 두 가지 관점으로 봅니다. 개발자가 REA를 쓰는 법, 그리고 앱 제작자가 알아야 할 방어 관점.
REA는 무엇인가 — 새 기술이 아니라 새 인터페이스
먼저 정체부터 명확히 하겠습니다. REA는 디스어셈블러가 아닙니다. AI 코딩 에이전트와 기존 역공학 도구를 이어주는 MCP 서버 + CLI입니다. TypeScript로 작성된 MIT 오픈소스이고, 밑에서 도는 엔진은 모두 구면입니다.
- Ghidra — NSA가 2019년 공개한 역공학 프레임워크
- Hopper — 2011년부터 있던 macOS 디스어셈블러 (무료 데모 모드 지원)
- IDA — 1990년대부터 이어온 업계 표준
즉 REA의 혁신은 “역공학을 잘하는 AI”가 아니라, 수십 년 된 전문가 도구를 에이전트가 스스로 운전하게 만든 연결층입니다. 당신은 Claude Code나 Cursor에 이렇게 말할 뿐입니다.
Notes 앱의 검색 기능이 어떻게 동작하는지 증거와 함께 설명하고,
내 프로젝트에 비슷한 기능을 만들어줘.
그러면 에이전트가 REA 도구를 순서대로 호출합니다: 바이너리 열기 → 문자열·함수 검색 → 교차 참조 추적 → 콜 그래프 재구성 → 핵심 함수 디컴파일 → 확보한 이해로 내 스택에 맞게 구현. 사람이 하던 5단계를 에이전트가 돌리고, 마지막 코드 작성은 에이전트가 원래 잘하던 일입니다.
분석할 수 있는 대상이 생각보다 넓다
네이티브 바이너리만 되는 게 아닙니다. 공식 README 기준 지원 목록이 상당히 광범위합니다.
| 대상 | 얻는 것 | 필요 도구 |
|---|---|---|
| 네이티브 바이너리 (Mach-O/ELF/PE) | 의사코드, 어셈블리, 문자열, 심볼, 호출 관계 | Hopper·Ghidra·IDA 중 1개 |
| JavaScript / Electron 앱 | 모듈, IPC 채널, preload, 소스맵 (실행 없이 정적 분석) | Node.js만 — 별도 엔진 불필요 |
| 웹사이트 | 페이지 구조, 스크립트, 네트워크 관찰, 스크린샷 | Chrome 계열 브라우저 |
| Android APK / 실기기 | 매니페스트, 디컴파일된 메서드, 로그, 화면 캡처 | JADX + JDK, adb |
| .NET 어셈블리 | 메타데이터, CIL 명령어, 빌드 비교 | 없음 (정적 분석) |
| Go·Rust 바이너리 | 컴파일러 버전, 모듈/크레이트 목록, 의존성 | 내장 정적 검사 |
| 펌웨어 | 영역 추출, 네이티브 분석 연계 | binwalk/Unblob (Linux) |
| SQLite / 네트워크 캡처 | 테이블·스키마, HAR/pcap 요청·응답 분석 | 로컬 스냅샷, TShark |
설계 철학도 짚을 만합니다. 모든 결과는 Evidence(증거) 레코드로 남아서 내보내기·버전 간 비교가 되고, 추측은 추측으로 표기합니다(“unknowns stay unknown”). 분석은 전부 로컬에서 돌고 외부 업로드 서비스는 없습니다. 다만 에이전트에 붙은 LLM 제공자의 데이터 정책은 별도 문제입니다.
설치와 첫 실행
Node.js 22.19+(또는 24.11+)와 npm만 있으면 시작합니다.
# 에이전트 자동 등록 (Claude Code·Codex·Cursor·Gemini CLI·Grok Build 감지)
npx rea-agents setup

# 환경 점검
rea doctor

# 터미널에서 직접 분석
rea analyze /Applications/Notes.app
rea search /Applications/Notes.app "offline"
rea trace /Applications/Notes.app "offline"
setup은 감지된 에이전트 목록과 변경할 파일을 보여주고 기본값이 “No”일 만큼 조심스럽게 동작합니다(--dry-run으로 미리보기 가능). 네이티브 심층 분석이 필요하면 Hopper(데모 모드 무료)나 기존 Ghidra 설치를 연결하면 됩니다. JavaScript·Electron 정적 분석은 엔진 없이 바로 돕니다.
실측으로 본 비용과 품질 — 공짜가 아니다
한 개발자가 자기 iPhone 앱을 대상으로 REA 유무 클론 테스트를 한 결과가 꽤 정직합니다.
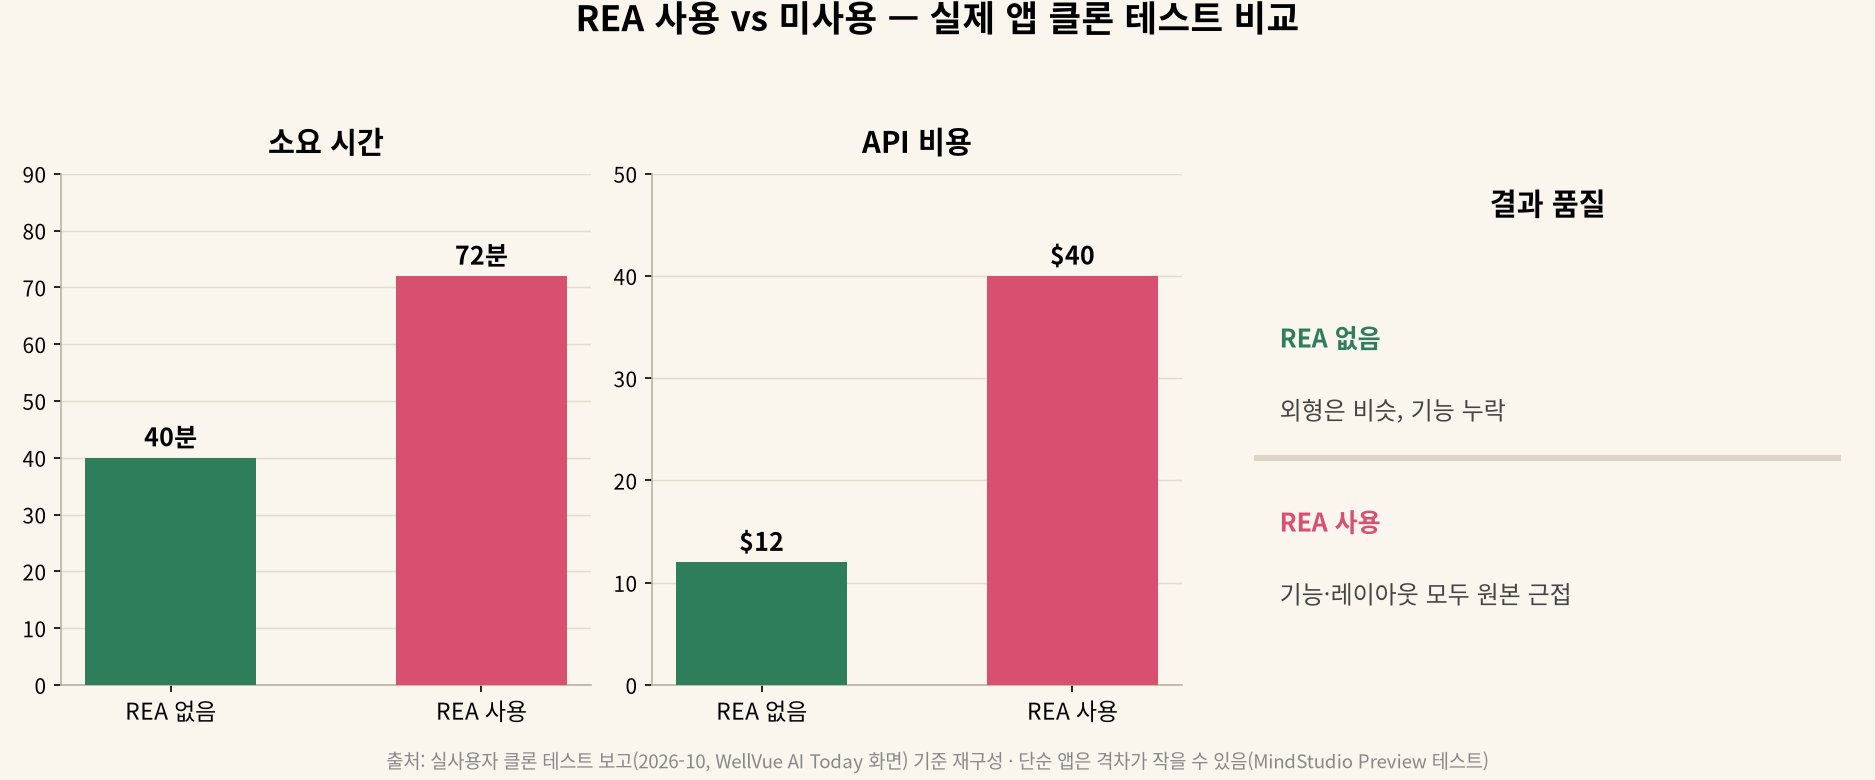
- REA 없이 (스크린샷+추론만): 약 40분, $12 — 외형은 비슷하지만 기능 누락
- REA 사용: 약 1시간 12분, $40 — 기능과 레이아웃 모두 원본에 훨씬 근접
MindStudio의 Preview 앱 재구현 테스트에서는 반대 결과도 나왔습니다. REA 없는 바닐라 에이전트가 더 빨리 끝냈고 결과 품질 차이가 크지 않았다는 것. 정리하면 단순한 유틸 앱은 에이전트 추론만으로도 되고, 복잡할수록 REA의 증거 기반 분석이 값을 한다는 그림입니다. 토큰 소모가 크니 정가 기준으로 예산을 잡아야 합니다.
에디터가 짚은 한계 3가지
공식 문서와 커뮤니티 반응을 교차 확인하며 정리한, 도입 전에 알아야 할 현실입니다.
- 모델 안전장치가 먼저 막는다: Reddit 실사용자 보고에 따르면 Claude Opus 5.5·Sonnet 5.5는 라우터 펌웨어 분석을 거부했습니다. 역공학 요청 자체가 모델 정책과 충돌하는 경우가 있어, 도구 설치만으로 만능이 아닙니다
- Windows는 실험적: macOS 12+와 주요 리눅스가 정식 지원이고, Windows x64는 Ghidra 한정 실험 단계입니다
- 법적 경계: REA 공식 입장은 “합법적 연구·교육·상호운용성·본인 소유 소프트웨어 분석”용입니다. 아이디어와 동작의 재구현은 괜찮아도 저작권 코드·자산 복제는 안 되고, Anthropic이 Claude Code 역공학을 DMCA로 차단한 사례처럼 EULA가 역공학을 금지하는 소프트웨어도 많습니다
도입 전 체크리스트
- ☐ macOS 또는 Linux 환경이고 MCP 지원 에이전트(Claude Code·Cursor·Codex 등)를 이미 쓰는가
- ☐ Node.js 22.19+ / 24.11+ 버전을 확인했는가 (
node -v) - ☐
npx rea-agents setup후rea doctor로 환경 점검을 마쳤는가 - ☐ 네이티브 분석이 필요하면 Hopper 데모 또는 Ghidra 12.1.2+JDK 21을 준비했는가
- ☐ 분석 대상 소프트웨어의 라이선스(EULA)가 역공학을 허용하는지 확인했는가
- ☐ 깊은 조사일수록 토큰 비용이 커진다는 점을 감안해 작은 타깃부터 테스트했는가
- ☐ (앱 제작자라면) 내 앱이 Electron/JS 기반이면 정적 분석에 사실상 무방비라는 점을 인지하고, 민감 로직은 서버로 옮겼는가
FAQ
REA 없이도 에이전트가 역공학을 할 수 있나요?
네, 어느 정도는 됩니다. 스크린샷과 동작 관찰만으로 재구현하는 방식이고, 간단한 앱은 이 편이 빠를 수도 있습니다(위 Preview 테스트). REA의 가치는 바이너리 수준의 증거 — 함수 호출 관계, 의사코드, IPC 흐름 — 가 필요한 복잡한 타깃에서 나옵니다.
원본 소스 코드를 그대로 복구해주나요?
아니요. 반환되는 것은 의사코드(pseudocode)와 어셈블리, 심볼, 문자열, 그리고 각 결론의 근거입니다. 원본 소스의 복원이 아니라 “동작 이해 + 내 스택으로 재구현”이 목적입니다.
분석한 앱이 외부로 업로드되나요?
REA 자체는 전부 로컬에서 분석하고 호스팅 서비스도 없습니다. 단, 에이전트가 받는 도구 결과는 결국 LLM 제공자 API로 흐르므로 해당 제공자의 데이터 정책은 별도 확인해야 합니다.
상용 도구 라이선스도 필요한가요?
IDA Pro, Hopper 유료판, JEB는 별도로 합법 취득해야 합니다. REA는 어떤 도구의 라이선스도 제공하지 않습니다. Ghidra는 무료이고, Hopper는 데모 모드로 시작할 수 있습니다.
결론
REA는 역공학을 “전문가의 수년간 훈련”에서 “에이전트에게 위임하는 작업”으로 바꾼 분기점입니다. 다만 과열된 화제(“소프트웨어는 끝났다”)와 실제 능력 사이에는 아직 간격이 있습니다 — 새 디컴파일 기술은 없고, 단순한 앱은 바닐라 에이전트로도 됩니다. 진짜 신호는 다른 곳에 있습니다. 코드 자체는 더 이상 해자가 아니고, 브랜드와 사용자, 데이터, 실행 속도가 해자가 되는 시대라는 것. 앱을 만드는 입장이라면 클라이언트에 무엇을 남길지 다시 점검하고, 배우는 입장이라면 macOS + Claude Code + npx rea-agents setup 조합으로 오늘 바로 시작해보면 됩니다.
함께 읽으면 좋은 글
- Paseo: Claude Code·Codex를 한 화면에서 지휘하는 오픈소스 오케스트레이션
- Grok Bot 완전 정리: 진짜 일을 맡기는 AI 팀원
- OpenAI Codex CLI 완전 가이드: AI 코딩 에이전트의 새 시대
- OpenClaw 보안 점검 완벽 가이드: AI 에이전트 시대의 필수 체크리스트