작성자: Apptics 에디터 — AI 모델·자동화 도구를 직접 조사해 실무 관점으로 정리하는 기술 블로그입니다. 이 글은 TypeSafe 공식 문서와 발표 자료를 기준으로 작성했습니다.
말을 안 하는 AI가 등장했다
챗봇, 코파일럿, 에이전트… 지금 나오는 AI는 전부 “글을 잘 쓰는” 모델이에요. 그런데 소프트웨어 입장에서 보면 이상한 일이 벌어집니다. LLM이 문장을 만들어내면, 우리 코드는 그 문장을 다시 파싱하고 검증하고, 혹시 헛소리(할루시네이션)가 섞였는지 걱정해야 하죠. 기계가 쓰는 글인데 결국 사람이 들여다봐야 하는 구조입니다.
2026년 9월 15일, TypeSafe AI가 정반대 방향의 모델을 공개했습니다. 이름은 Jev. 텍스트를 한 글자도 생성하지 않습니다. 대신 미리 정의한 선택지 중 하나를 고르고, 그 결정에 대한 확률과 신뢰도(confidence)를 함께 돌려줘요. 발표 당일 해커뉴스 1위를 종일 지켰고, “LLM을 대체할 구조화 분류기”라는 평가와 “마케팅이 과하다”는 비판이 동시에 쏟아졌습니다. 도대체 뭐길래 그럴까요?
System One 모델이란 무엇인가
‘System One’이라는 이름은 대니얼 카너먼의 《생각에 관한 생각》에서 가져왔어요. 빠르고 직관적인 시스템 1 사고와, 느리고 숙고하는 시스템 2 사고의 구분에서요. Jev는 이 중 시스템 1 — 1초 안에 내릴 수 있는 빠르고 정확한 판단만 담당하는 모델 클래스입니다. 모델명 ‘Jev’는 제본스 역설(Jevons Paradox)에서 따왔는데, “지능의 가격이 떨어질수록 사용량은 오히려 폭발한다”는 베팅이 담겨 있습니다.
만든 곳은 샌프란시스코의 TypeSafe AI. 창업자 디오고 알메이다(Diogo Almeida)는 OpenAI에서 RLHF와 인스트럭션 튜닝 연구에 참여해 ChatGPT의 기반을 만든 인물로 알려져 있고, 회사는 4,000만 달러를 유치한 뒤 2년간 스텔스 모드로 개발하다 이번에 나왔습니다.
핵심 차이는 학습 방식입니다. 기존 LLM이 인간 선호에 맞추는 RLHF, 검증 가능한 보상에 맞추는 RLVR로 학습하는 것과 달리, Jev는 RLCD(Reinforcement Learning for Calibrated Decisions, 보정된 결정을 위한 강화학습)로 학습해요. 목표가 “사람이 좋아하는 글”이 아니라 “정직하게 보정된 확률을 가진 결정”입니다.
작동 방식: 텍스트가 아니라 타입이 나간다
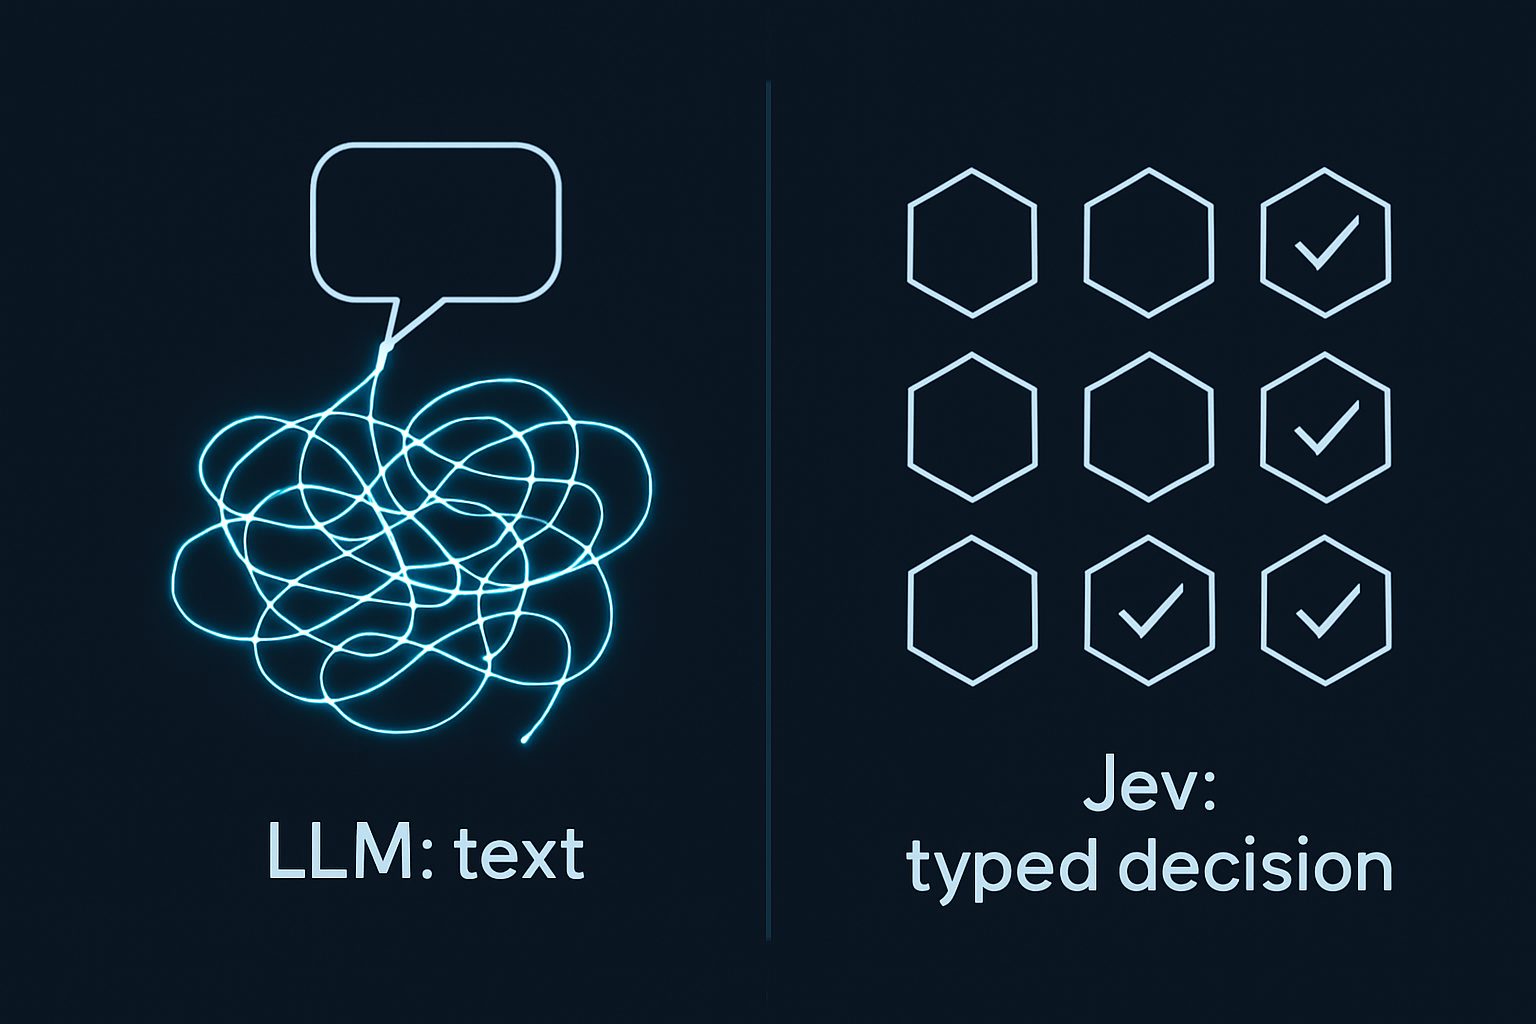
LLM은 토큰을 하나씩 순차 생성하지만, Jev는 모든 답변을 한 번의 병렬 연산으로 반환합니다. 사용법은 함수 호출과 비슷해요. 프로그램 상태(state)와 타입이 정해진 질문(questions)을 보내면, 선언한 선택지 안에서만 답이 나옵니다. 질문 프리미티브는 딱 3가지입니다.
- Choice — 선택지 중 하나 고르기. 티켓을 영업/지원/스팸 중 어디로 보낼지 라우팅할 때. 선택지는 최대 255개.
- Score — 순서가 있는 등급으로 평가하기. 고객 불만 정도를 3단계로 나눌 때.
- Noul — 예/아니오 확률(0~1) 하나만 받기. “이 메시지가 환불 요청인가?” 같은 질문.
답변마다 확률 분포와 confidence 값이 붙어서, 코드가 “신뢰도 0.9 이상이면 자동 처리, 미만이면 사람한테 에스컬레이션” 같은 분기를 직접 짤 수 있어요. 같은 요청 안의 질문들은 모두 병렬 평가라, 질문 13개를 한 번에 묶어도 13번 따로 부르는 것보다 11.5배 저렴하다는 공식 쿡북 수치도 있습니다.
숫자로 보는 Jev: 속도·가격·스펙
TypeSafe가 공개한 수치와 공식 문서 기준 스펙을 표로 정리했어요.
| 항목 | 일반 프론티어 LLM | Jev (jev-1.13.0) |
|---|---|---|
| 출력 | 자유 텍스트 (파싱·검증 필요) | 타입이 정해진 결정 + 확률 |
| 샘플링 | 토큰 단위 순차 생성 | 전체 답변 병렬 1회 연산 |
| 응답 시간 | 3초~329초 | 70~500ms (워크플로 기준 최대 193.6배 빠름) |
| 입력 가격 | $0.20~$10 / MTok | $0.042 / MTok ($42/Btok) |
| 출력 가격 | 입력의 약 5배 | 무료 |
| 컨텍스트 | 수십만 토큰 | 총 64k 토큰 (state+최장 질문 32k) |
| 입력 형식 | 텍스트·이미지 등 | 텍스트 전용 (이미지·오디오 불가) |
| 신뢰도 | 물어도 과신하는 경향 | 모든 답변에 보정된 confidence 제공 |
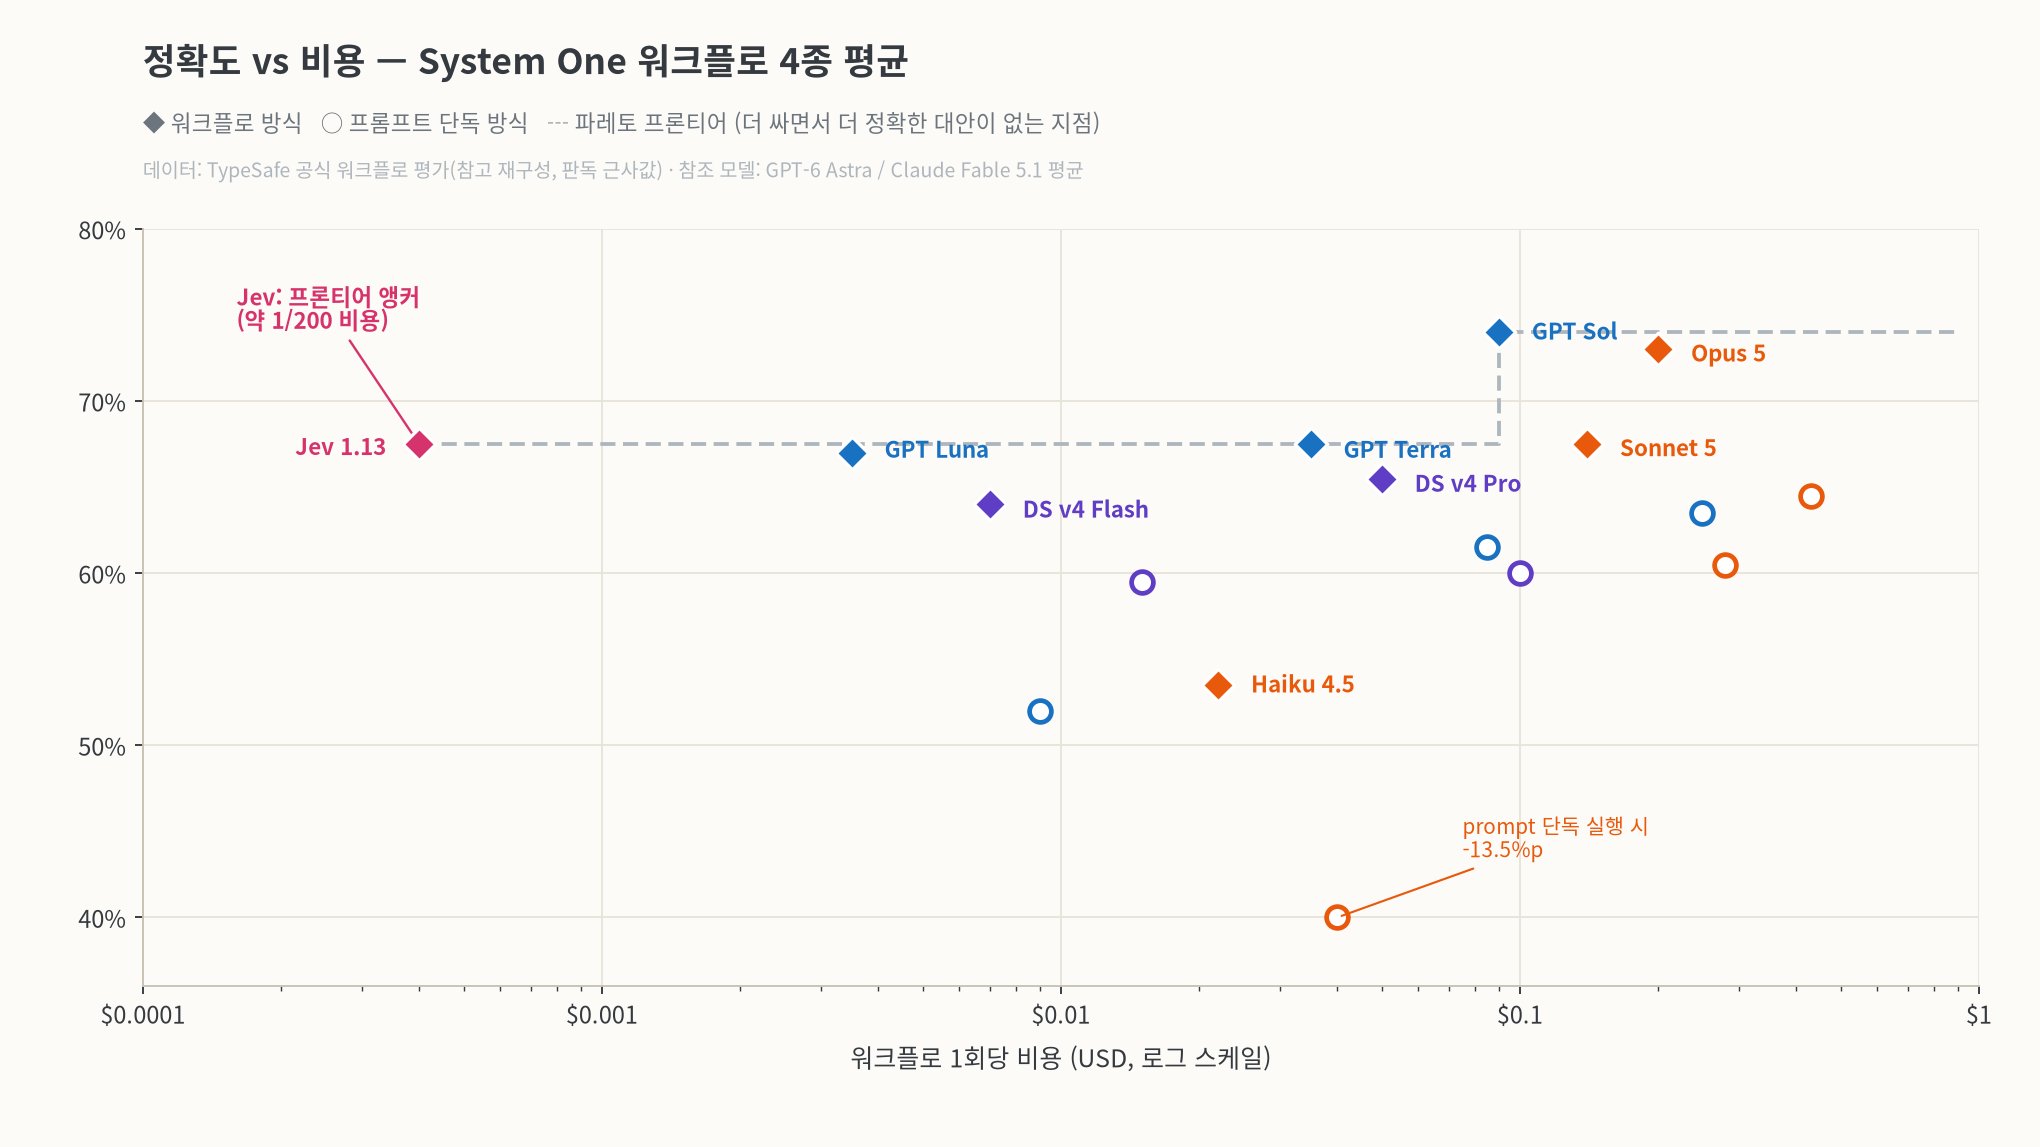
가격은 Claude Fable 5.1 입력 단가보다 238배 낮다고 공식 사이트에 명시돼 있어요. “193.6배 빠르고 444.6배 싸다”는 대표 수치는 TypeSafe가 자체 설계한 워크플로 평가 기준이고, 회사 스스로도 “실세계에서 기대할 수 있는 상단 값”이라고 인정했습니다. 참고로 Rate limit은 초당 25만 토큰, 분당 1,200 요청입니다.
“할루시네이션 제로”라는 주장, 어디까지 믿을까
공식 홈페이지에는 Zero Hallucinations이라는 문구가 크게 걸려 있어요. 이게 가능한 이유는 구조 때문입니다. Jev는 문자열을 생성하지 않아요. 개발자가 선언한 선택지 밖으로는 물리적으로 답을 내놓을 수 없으니, 존재하지 않는 API를 지어내거나 JSON 스키마를 깨는 구조적 할루시네이션은 수학적 발생 불가가 맞습니다.
하지만 해커뉴스에서 300개 넘는 댓글이 지적했듯, 이건 “틀린 답”이 없다는 뜻이 아니에요. Jev가 신뢰도 0.95로 “이 티켓은 스팸”이라고 답했는데 실제로는 스팸이 아닐 수 있습니다. 자신만만한 오답은 보정된 모델과 완전히 양립 가능하죠. 문서 1만 건을 95% 정확도로 태깅하면 500건은 여전히 잘못 분류되고, 모델은 그 500건에 손들지 않아요. 결국 confidence 임계값 설계와 사람 검수 루프는 개발자 몫입니다.
직접 확인한 점 / 에디터 의견
공식 문서의 ‘jaggedness(거친 부분)’ 페이지가 인상적이었어요. 보통 벤더는 약점을 숨기는데, TypeSafe는 jev-1.13의 실패 모드를 표로 공개했습니다. 문서를 기준으로 정리하면: 숫자 세기·수학 연산은 믿으면 안 되고 코드에서 처리, 날짜 비교는 텍스트로 읽어 신뢰 불가(추출만 시키고 계산은 코드로), 이중 부정이나 우회 지시는 정확도 하락, state에 무관한 정보가 많으면 정확도가 떨어짐(context rot), 적대적 입력(프롬프트 인젝션)에는 취약. 그리고 고객 데이터로 파인튜닝하지 않아 모든 계정이 같은 가중치를 씁니다 — 커스터마이징은 state와 질문 설계로만 해야 해요.
제 판단으로는 Jev는 “LLM 대체재”가 아니라 LLM 앞단의 저비용 판단 레이어에 가까워요. 의도 분류, 라우팅, 가드레일 검사처럼 초당 수십 번 도는 판단은 Jev에 맡기고, 진짜 생성·추론이 필요할 때만 비싼 LLM을 부르는 캐스케이드 구조가 가장 현실적인 활용법입니다. 실제 공식 쿡북도 LLM 가드레일, RAG 패시지 필터링, 인용 검증처럼 “다른 모델을 검문하는” 용례가 다수예요.
지금 바로 시작하려면: 실무 체크리스트
- ✅ 웨이트리스트 등록 — 현재 얼리 액세스 단계. console.typesafe.ai에서 신청 후 플레이그라운드로 체험
- ✅ Netlify 사용자라면 AI Gateway로 무설정 연동 —
@typesafe-ai/sdk설치만으로 Functions에서 사용, 별도 API 키 불필요 - ✅ 판단을 “원자 질문”으로 쪼개기 — 복합 평가는 Score 여러 개로 분해 후 코드에서 가중치 합산
- ✅ confidence 임계값 3단 설계 — 높음(자동 처리) / 중간(확인 요청) / 낮음(사람 라우팅)
- ✅ 수학·날짜·집계는 절대 Jev에 맡기지 않기 — 추출만 시키고 계산은 코드에서
- ✅ state는 질문이 필요한 필드만 필터링해서 전송 — 32k 토큰 예산 관리 겸 정확도 확보
- ✅ 배포 전 적대적 입력 엣지 케이스 테스트 — 인젝션 방어는 아직 미완
SDK는 Python(비동기/동기)과 JavaScript(Node.js 20+)를 제공하고, Claude Code·Codex용 에이전트 스킬도 문서에 있어요. 모델 별칭은 jev-latest, 버전 고정은 jev-1.13.0을 쓰면 됩니다.
FAQ
Q1. Jev는 그냥 작은 LLM인가요?
아니요. 아키텍처와 학습 알고리즘(RLCD)이 다르고, 텍스트 생성 기능 자체가 없습니다. “프론티어급 지능을 가진 함수 호출”에 가까워요. LLM처럼 글을 쓰게 하는 용도로는 쓸 수 없습니다.
Q2. JSON 모드나 구조화 출력(structured outputs)과 뭐가 다른가요?
JSON 모드는 LLM이 텍스트를 생성한 뒤 스키마에 맞추는 후처리 성격이고, 생성 실패·파싱 오류 가능성이 남아요. Jev는 애초에 문자열을 생성하지 않고 선언된 선택지에서 확률을 계산해 반환하니 스키마 위반이 구조적으로 불가능합니다.
Q3. 가격은 계속 이런가요? 일시 보조 아닌가요?
TypeSafe는 “가격은 내려가면 내려갔지 올라가지 않을 것”이라면서도, 장기 지속가능성은 시간으로 증명하겠다고 밝혔어요. 출력 토큰 무료 정책도 조기 도입자를 위한 현재 조건입니다.
Q4. 한국어 입력도 되나요?
공식 문서에 언어 지원 섹션이 있고 자연어 입력을 이해하지만, 평가·문서 예제는 영어 중심이에요. 한국어 상태(state)에 대한 정확도는 플레이그라운드로 직접 검증 후 투입하는 걸 권합니다.
결론: 생성의 시대에 등장한 ‘결정’ 전용 모델
Jev는 “더 똑똑한 글쓰기” 경쟁에서 빠지고, 소프트웨어가 직접 소비하는 결정이라는 새 카테고리를 열었습니다. 70~500ms 응답, 입력 $42/Btok·출력 무료라는 경제성은 분류·라우팅·가드레일처럼 판단이 대량으로 도는 지점에서 LLM 비용을 자릿수 차이로 줄일 수 있는 카드예요. 다만 “할루시네이션 제로”는 구조적 출력에 한정된 표현이고, 자신만만한 오답과 적대적 입력 취약성은 여전히 개발자가 설계로 방어해야 합니다. 얼리 액세스가 열려 있는 지금, 웨이트리스트에 등록해 플레이그라운드로 내 워크플로에 맞는지 먼저 검증해보는 걸 추천해요.
함께 읽으면 좋은 글
- GPT-6 Astra 공개: 벤치마크·가격·사이버 등급 완전 정리
- Claude Fable 5.1 출시: 캐시 읽기 75% 인하, 개발자가 꼭 확인할 3가지
- 2026 AI 에이전트 도입 가이드: 진짜와 가짜를 구별하는 7가지 기준
- DeepSeek V4.1 Flash: 플래그십을 스스로 은퇴시킨 모델, 뭐가 다르길래
- GPT-5.6 모델별 차이점: Sol·Terra·Luna 가격·성능·용도 완전 정리